-
Jev로 모델을 라우팅해도 되는가 — '싸게 결정하기'는 풀렸지만 '맞게 고르기'는 아직 열린 문제다IT 2026. 10. 31. 11:30
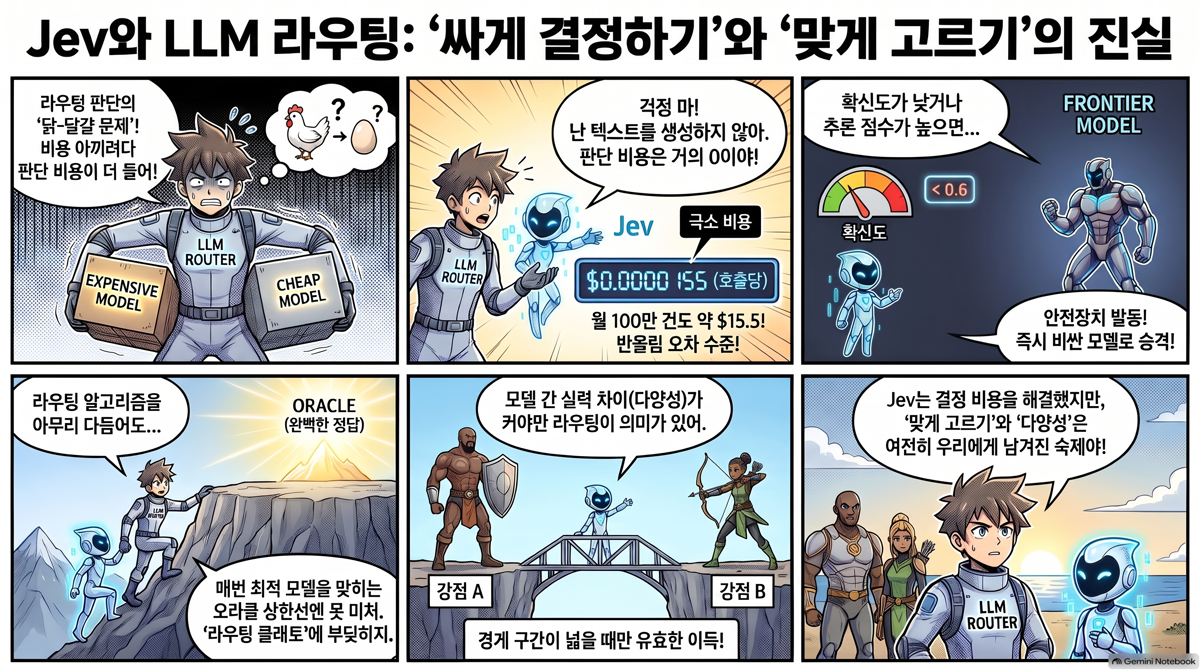
▶ 동영상 개요 — Jev로 모델을 라우팅해도 되는가 — '싸게 결정하기'는 풀렸지만 '맞게 고르기'는 아직 열린 문제다
10분 9초 — Jev는 라우팅 '결정을 싸게 내리는' 닭-달걀 문제(라우터가 또 다른 비싼 LLM 호출이 되는 문제)는 구조적으로 풀지만, '고른 모델이 정말 최선인가'는 못… — NotebookLM 동영상 개요로 생성 🎧 오디오 개요 — Jev로 모델을 라우팅해도 되는가 — '싸게 결정하기'는 풀렸지만 '맞게 고르기'는 아직 열린 문제다
31분 36초 — Jev는 라우팅 '결정을 싸게 내리는' 닭-달걀 문제(라우터가 또 다른 비싼 LLM 호출이 되는 문제)는 구조적으로 풀지만, '고른 모델이 정말 최선인가'는 못…. 화면은 이 글의 인포그래픽 한 장 고정 — NotebookLM 오디오 개요로 생성 집에 둔 AI 서버로 에이전트를 여러 개 돌리다 보면, 토큰 청구서를 줄이려고 가장 먼저 손대는 것이 모델 라우팅이다. 쉬운 질문은 싸고 빠른 모델로, 어려운 질문만 비싼 모델로 나눠 보내는 방식이다. 그런데 여기서 성가신 닭-달걀 문제가 하나 생긴다. "이 질문이 쉬운지 어려운지"를 누가 판단할 것인가? 그 판단을 또 LLM에게 맡기면, 아끼려던 한 번의 호출을 아끼려고 다른 한 번의 호출을 새로 치르는 꼴이 된다.
그 빈자리에 딱 맞는 후보가 하나 등장했다. Jev다. TypeSafe AI가 2026년 9월에 내놓은, 글자를 전혀 생성하지 않고 결정만 확신도와 함께 돌려주는 모델이다. 만든 사람은 ChatGPT로 이어진 InstructGPT 논문의 공저자이고, 회사는 이것을 "첫 번째 System One(시스템 1) 모델"이라고 부른다 — 느리게 추론하는 LLM과 달리 즉각적인 판단만 내린다는 뜻이다. 라우팅은 본질적으로 "어느 모델로 보낼까"라는 짧은 결정이니, Jev를 라우터로 세우자는 발상은 자연스럽다. 이 글은 그 발상이 정말 유효한지를 공개 벤치마크와 2026년 논문들로 따져본다. 미리 결론을 당기면, 유효한 부분과 아직 열려 있는 부분이 깨끗하게 갈린다.
라우팅에는 서로 다른 두 질문이 숨어 있다
"Jev로 라우팅해도 되는가"에 답하려면, 먼저 라우팅이라는 한 단어가 사실은 두 개의 다른 질문을 겹쳐 담고 있다는 것을 봐야 한다. 하나는 "결정을 싸게 할 수 있는가"이고, 다른 하나는 "그 결정이 맞는가"이다. 이 둘은 전혀 다른 난이도를 가진다.

다이어그램 설명. 이 그림이 보여주는 건 "라우팅"이 사실 한 덩어리가 아니라는 점이다. "결정을 싸게 할 수 있나"라는 갈래는 공학 문제다 — 판단을 내리는 데 드는 시간과 돈을 어떻게 0에 가깝게 낮추느냐의 문제이고, Jev가 정확히 이 자리를 겨눈다. 반면 "그 결정이 맞나"라는 갈래는 질이 다르다 — 질문만 보고 어느 모델이 이길지 미리 아는 것은, 모델을 실제로 돌려 보기 전에는 누구도 확실히 알 수 없는 예측 문제다. 놓치기 쉬운 함정이 바로 여기다. Jev가 앞 갈래를 멋지게 풀었다고 해서 뒤 갈래까지 풀리는 것이 아니다. 뒤 갈래는 Jev를 쓰든 다른 무엇을 쓰든 똑같이 남는, 모델과 무관한 난제다. 글의 나머지는 이 두 갈래를 차례로 본다.
싼 결정 — 이쪽은 Jev가 깨끗하게 푼다
먼저 쉬운 갈래부터 보자. 라우터를 세울 때 가장 먼저 부딪히는 벽은 "라우터 자체의 값"이다. 싼 모델과 비싼 모델의 단가 차이가 라우팅의 이득인데, 그 판단을 또 다른 LLM에게 맡기면 round-trip(요청·응답 왕복)이 하나 더 붙어 이득을 거의 다 까먹는다. Jev는 이 왕복을 없앤다. 글자를 한 자씩 뽑는 생성 과정이 아예 없어서, 상황과 미리 정해둔 질문을 한 번의 병렬 계산으로 평가하고 끝낸다.
라우터로 쓸 때의 구조는 이렇다. 사용자 메시지를 Jev에 넣어 "난이도를 고르는 선택 질문"과 "추론량을 매기는 점수 질문"을 동시에 받고, 그 결과를 평범한 코드가 모델 티어에 매핑한다.

다이어그램 설명. 이 흐름의 핵심은 "어떤 생성 모델도 부르기 전에 라우팅이 끝난다"는 것이다. 사용자 메시지만 보고 — 시스템 프롬프트나 대화 히스토리를 걷어내 입력을 작게 유지한 채 — Jev가 난이도 선택과 추론 점수를 한꺼번에 돌려주고, 그걸 두 개의 안전장치로 거른다. 선택 확신도가 기준선(0.6)에 못 미치면 티어 판정을 믿지 않고 프런티어 모델로 올리고, 확신도가 충분해도 추론 점수가 높으면 티어와 무관하게 다시 프런티어로 올린다. 둘 다 통과한 질문만 싼·중간 모델로 내려간다. 왜 이렇게 설계하는가? 라우터가 저지를 수 있는 실수는 두 종류인데 — 쉬운 걸 비싸게 보내는 낭비와, 어려운 걸 싸게 보내는 품질 사고 — 뒤쪽이 훨씬 아프기 때문이다. 그래서 확신이 없을 땐 항상 비싼 쪽으로 기운다. 이 "애매하면 비싼 쪽"이 유효성의 열쇠인데, 이건 뒤에서 다시 다룬다.
값은 어느 정도일까. 공개된 커뮤니티 예시 하나는 "호주의 수도는?" 같은 질문에 대한 라우팅 판단이 왕복 포함 약 458밀리초(네트워크를 빼면 260밀리초 안팎), 호출당 0.0000155달러로 끝났다고 보고한다. 월 100만 건을 라우팅해도 라우터 값만 따지면 약 15.5달러다. 이 숫자가 중요한 이유는, 라우터가 고르는 모델 호출 한 번의 값에 비하면 거의 반올림 오차로 사라지기 때문이다. TypeSafe는 분류 과제에서 비슷한 LLM 대비 "최대 200배 빠른 추론, 400배 낮은 비용"을 주장한다 — 벤더 주장이라 곧이곧대로 받을 숫자는 아니지만, 라우팅 결정의 값을 0에 가깝게 눌렀다는 방향만큼은 구조상 분명하다. 즉 "결정을 싸게 하기"는 Jev가 설계상 깨끗하게 푼다.
그런데 '싸다'는 '맞다'가 아니다
많은 글이 여기서 "라우팅 값이 0이니 공짜 점심"이라는 결론으로 건너뛴다. 하지만 빠르고 싼 결정이라도 틀린 결정이면 여전히 틀린 것이다. 어려운 질문을 싼 모델로 잘못 내려보내면, 그 질문의 답 품질이 그 자리에서 무너진다. 라우팅이 아끼는 돈보다 그 한 번의 오답이 더 비쌀 수 있다. 그러니 "Jev로 라우팅해도 되는가"의 진짜 무게는 속도가 아니라 정확도에 실린다 — Jev가 고른 티어가 정말 그 질문에 최선이었는가?
Jev의 확신도(calibrated confidence, 보정된 확률)는 이 지점에서 도움을 준다. 확신이 낮으면 비싼 쪽으로 올리는 안전장치가 그래서 있다. 하지만 확신도는 "내가 이 질문을 trivial로 분류한 게 맞을 확률"을 말할 뿐, "이 질문에서 싼 모델이 비싼 모델만큼 잘할 확률"을 직접 말하지는 않는다. 둘은 미묘하게 다른 예측이다. 그리고 뒤쪽 예측 — 어느 모델이 이 질문에서 이길지를 미리 맞히는 것 — 이 바로 라우팅 연구가 10년 가까이 씨름해 온, 모델을 바꿔도 사라지지 않는 핵심 난제다.
학계가 말하는 것 — 라우터는 '플래토'에 걸린다
라우팅이 실제로 얼마나 잘 되는지는 이제 벤치마크로 잴 수 있다. RouterBench는 11개 LLM을 7개 과제(MMLU·GSM8K·MBPP 등)에 걸쳐 40만 건 넘게 미리 돌려 둔 데이터로 라우터들을 비교하는 공개 벤치마크다. 2025년의 RouterEval, 그리고 2026년 ICLR에 나온 RouterArena는 더 많은 모델과 도메인으로 라우터를 리더보드 식으로 세운다. 이들이 공통으로 쓰는 기준이 세 가지인데, 여기에 '플래토'를 더해 네 수준을 한 사다리로 놓으면 라우팅의 현주소가 또렷해진다.

다이어그램 설명. 이 사다리는 라우팅 성능의 네 수준을 기준선에서 상한까지 한 단계씩 이어 놓은 것이다 — 화살표는 흐름이 아니라 "한 단계 더 높은 수준"을 뜻한다. 출발점인 "단일 최강 모델 하나로 전부"는 라우팅을 안 한 기준선이다. 다음 단계 "현실의 라우터"는 기준선과 비슷한 품질을 더 싸게 내므로 이득이 분명하다 — 라우팅이 헛소리가 아니라는 증거다. 문제는 그다음 단계인 "라우팅 플래토"다. 2026년의 한 논문(제목 그대로 "The Routing Plateau")은 라우터가 어느 선에 닿으면 모델을 더 넣거나 라우팅 알고리즘을 더 정교하게 다듬어도 정확도가 거의 오르지 않는 축소 불가능한 오차 바닥(irreducible error floor)에 걸린다고 보고한다. 마지막 단계 "오라클"은 모든 질문에 대해 최적 모델을 미리 안다고 가정한 상한인데, RouterArena는 현실의 라우터와 이 오라클 사이에 아직 상당한 틈이 남아 있다고 — 라우팅은 풀린 문제가 아니다라고 결론짓는다. 함정은 "라우터가 좋아지면 언젠가 오라클에 닿겠지"라는 기대인데, 플래토는 그 기대가 구조적으로 틀렸음을 말한다.
왜 천장이 생기는가? 라우터는 질문만 보고 어느 모델이 이길지를 맞혀야 하는데, 모델들의 실력 범위가 서로 겹치는 구간에서는 그 구분이 원리적으로 애매해진다. 쉬운 질문은 둘 다 맞히고 아주 어려운 질문은 둘 다 틀리니 라우팅이 의미 없고, 라우팅이 값을 하는 건 "한쪽만 맞히는" 경계 구간뿐이다. 그 경계는 질문의 미세한 결에 달려 있어, 글자만 보고 완벽히 가르는 것은 불가능에 가깝다. Jev의 속도도, 더 큰 분류기도 이 바닥을 뚫지 못한다 — 바닥의 원인이 분류기의 성능이 아니라 문제 자체의 모호함이기 때문이다.
그럼 라우팅은 언제 '유효'한가 — 모델이 실제로 갈려야 한다
플래토가 있다고 라우팅이 무의미한 건 아니다. 다만 유효한 조건이 따로 있다. 2026년의 또 다른 논문("When is Routing Meaningful?")은 그 조건을 한 단어로 짚는다 — 다양성(diversity)이다. 라우팅은 구성 모델들의 강점과 약점이 실제로 갈릴 때만 이득을 낸다. 모델들이 서로 비슷하면, 아무리 똑똑한 라우터를 붙여도 얻을 게 없다. 이 차이를 두 경우로 나눠 본다.

▲ 경우 하나 — 강·약이 갈리는 모델들
다이어그램 설명. 이 그림은 라우팅이 이득을 내는 전제 조건을 그린다. 같은 질문 모음을 "쉬운 건 맞히고 어려운 건 자주 틀리는" 작은 모델과 "어려운 것까지 맞히는" 큰 모델에 각각 던지면, 둘의 실력이 갈리는 질문이 많이 생긴다 — 작은 모델로 충분한데 큰 모델을 부르면 낭비이고, 반대면 사고다. 바로 이 "한쪽만 맞히는 경계 구간"이 넓을수록 라우터가 아낄 여지가 커진다. Jev를 라우터로 쓸 값어치가 있는 건 정확히 이런 판이다.

▲ 경우 둘 — 실력이 엇비슷한 모델들
다이어그램 설명. 이 그림은 라우팅이 헛도는 경우다. 두 모델의 실력이 엇비슷하면 어느 질문을 어디로 보내든 결과가 거의 같다 — 경계 구간이 좁아 라우터가 아낄 것도, 사고를 막을 것도 많지 않다. 이 논문의 실용적 결론이 여기서 나온다. 정교한 라우팅 알고리즘을 고민하기 전에 서로 충분히 다른 모델을 고르는 것이 먼저다. 라우터가 아니라 모델 구성이 유효성의 8할을 정한다. 내 집 서버로 옮기면 이렇다 — 싼 티어와 비싼 티어의 단가뿐 아니라 실력 차이가 실제로 벌어져 있어야 Jev 라우팅이 값을 한다. 비슷비슷한 모델 사이에 라우터만 끼우면, 플래토에 걸리기도 전에 애초에 가를 것이 없다.
정리 — 반은 풀렸고, 반은 아직 열려 있다
"Jev로 모델을 라우팅해도 되는가"에 대한 정직한 답은 둘로 갈린다. 라우팅 결정을 싸고 빠르게 내리는 문제 — 라우터가 또 다른 비싼 LLM 호출이 되어 이득을 까먹는 닭-달걀 문제 — 는 Jev가 구조적으로 푼다. 글자를 생성하지 않는 결정 전용 모델이라 라우터 값이 반올림 오차로 사라지고, 확신이 낮으면 비싼 쪽으로 기우는 안전장치까지 갖췄다. 이 부분은 믿고 써도 된다.
하지만 고른 모델이 정말 최선인지는 Jev의 몫이 아니라 라우팅이라는 문제 자체의 몫이고, 이쪽은 아직 열려 있다. 공개 벤치마크는 현실의 라우터가 오라클에 한참 못 미치는 플래토에 걸린다고 말하고, 그 유효성마저 모델들의 강·약이 실제로 갈릴 때만 성립한다고 말한다. 그러니 한 줄로 남기면 이렇다 — Jev는 '라우팅을 싸게 하는 법'을 풀었지, '무엇이 최선인지 아는 법'을 푼 게 아니다. 집 서버에 Jev 라우터를 붙일지 정하기 전에, 먼저 내 티어의 모델들이 서로 충분히 다른지부터 정직하게 보는 게 순서다. 모델이 갈려 있고 단가 차이가 크면 Jev 라우팅은 분명한 이득이고, 그렇지 않으면 아무리 빠른 라우터도 아낄 것이 없다.
참고한 공개 자료:
- TypeSafe AI, Jev 소개 — System One 모델, Choice·Score·확률 질문: langchain.com/blog/building-a-harness-with-jev
- Jev를 LLM 라우터로 쓰기(티어·확신도 기준선·값 예시): jev-agent.com/use-cases/llm-model-routing
- RouterBench: A Benchmark for Multi-LLM Routing System: openreview.net/pdf?id=IVXmV8Uxwh
- RouterArena: An Open Platform for Evaluating LLM Routers (ICLR 2026): proceedings.iclr.cc — RouterArena
- The Routing Plateau: Understanding and Breaking the Accuracy Limits of LLM Routers: arxiv.org/pdf/2606.07587
- When is Routing Meaningful? Diversity and Robustness in Language Model Societies: arxiv.org/pdf/2607.09197
이 글은 생성형 AI의 도움을 받아 작성되었습니다. 원본 자료를 기반으로 AI가 초안을 생성하고, 작성자가 검토·편집하였습니다.
'IT' 카테고리의 다른 글
ChatGPT·Claude·Gemini·Grok 토큰 가격 비교 — 표에 적힌 단가는 실제 청구서의 출발점일 뿐이다 (0) 2026.11.01 안드로이드는 오픈소스인가 — 오픈소스 이니셔티브의 10개 조항으로 하나씩 따져본다 (0) 2026.11.01 Meta Muse — 답을 주는 챗봇에서 일을 떠안는 에이전트로 (0) 2026.10.31 prompt-audit — 모델을 올릴 때 진짜 바꿔야 하는 건 프롬프트에 박아둔 옛 변명이다 (0) 2026.10.31 안드로이드는 오픈소스인가 — '오픈소스'라는 한 단어가 숨긴 두 개의 질문 (0) 2026.10.30 리스크 기반 테스트는 어디서 왔나 — '전부 똑같이 테스트한다'가 깨진 자리 (0) 2026.10.29 Jev는 정말 토큰을 줄이는가 — 글자를 쓰지 않는 결정 전용 AI 모델의 원리와 한계 (0) 2026.10.28 Jev와 액션 모델 — 범용 LLM을 결정과 실행으로 쪼개는 두 흐름 (0) 2026.10.28 DevGPT는 개발자의 프롬프트를 커밋에 잇는다 — AI가 받은 질문과 '채택된 답'에서 암묵지를 캐려는 움직임 (0) 2026.10.27 Android Studio Journeys — 자연어로 쓴 테스트를 Gemini가 눈으로 보고 실행한다 (0) 2026.10.25