-
회귀 테스트는 왜 '회귀'인가 — 되던 것이 조용히 나빠지는 걸 막는 그물IT 2026. 10. 2. 21:00
▶ 동영상 개요 — 회귀 테스트는 왜 '회귀'인가 — 되던 것이 조용히 나빠지는 걸 막는 그물
6분 9초 — 회귀 테스트는 별도의 테스트 '종류'가 아니라 '되던 것이 변경 때문에 조용히 나빠지는 회귀를 막는다'는 목적이며, 그 회귀 스위트는 처음부터 설계되는 게 아니… — NotebookLM 동영상 개요로 생성 🎧 오디오 개요 — 회귀 테스트는 왜 '회귀'인가 — 되던 것이 조용히 나빠지는 걸 막는 그물
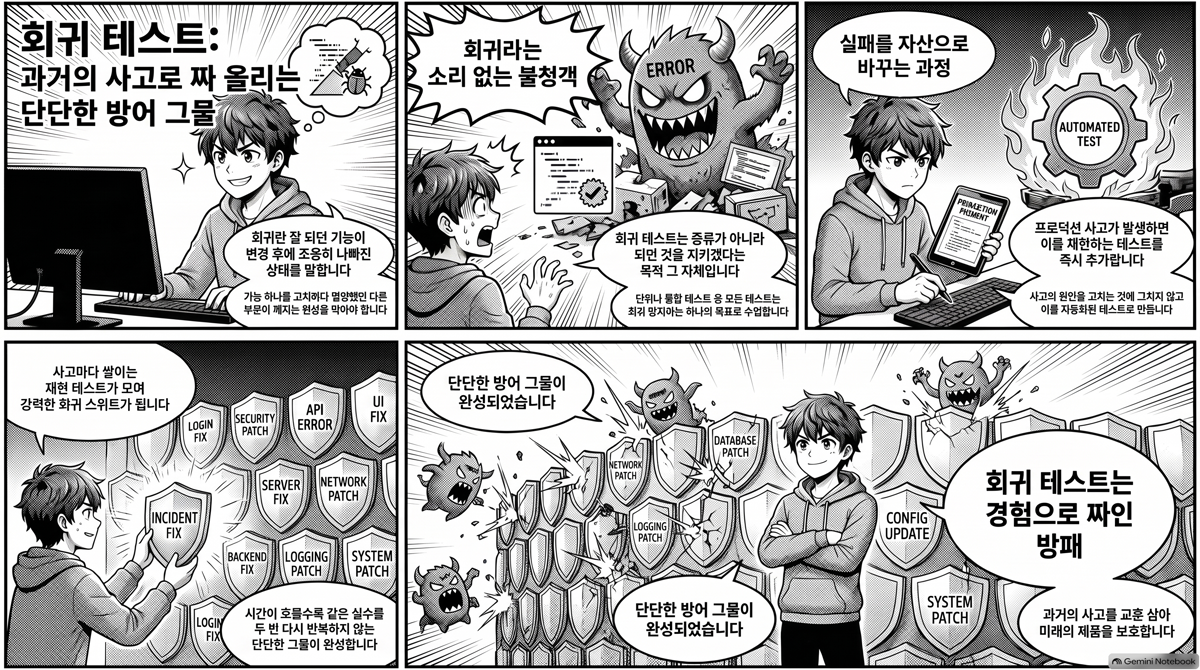
20분 48초 — 회귀 테스트는 별도의 테스트 '종류'가 아니라 '되던 것이 변경 때문에 조용히 나빠지는 회귀를 막는다'는 목적이며, 그 회귀 스위트는 처음부터 설계되는 게 아니…. 화면은 이 글의 인포그래픽 한 장 고정 — NotebookLM 오디오 개요로 생성 지난 글에서 스테이징과 프로덕션을 왜 따로 두는지, 배포 직후 왜 얕은 스모크 테스트를 다시 돌리는지를 다루면서 한 문장을 슬쩍 흘려 두었다. "모든 스모크 테스트를 통과한 빌드가, 카나리에서야 잡히는 회귀를 안고 나가는 경우가 있다"는 대목이다. 그때 "회귀"라는 단어를 풀지 않고 넘어갔다.
그런데 이 단어가 사실 테스트 세계에서 가장 오해받는 이름이다. 많은 사람이 회귀 테스트를 "예전에 만들어 둔 테스트 케이스를 모아 둔 폴더, 배포 전에 한 번 쭉 돌리는 그것"쯤으로 안다. 틀린 말은 아니지만, 그건 회귀 테스트가 어떻게 생겼는지를 말할 뿐 무엇인지는 아니다. 이름 자체에 답이 들어 있는데도 그냥 지나친다. 이 글에서는 그 이름에서 출발해 목적, 그리고 배포 파이프라인에서의 역할까지 하나로 이어 보려 한다.
왜 하필 '회귀'인가 — 이름이 곧 정의다
회귀(regression)라는 영어 단어의 원뜻은 통계나 머신러닝에서 쓰는 "회귀 분석"의 그 회귀가 아니다. 여기서는 "되돌아감, 퇴행, 이전보다 나빠진 상태로 후퇴함"이라는 일상적 의미다. 잘 걷던 사람이 다시 기어다니게 되면 "퇴행했다"고 말하는, 딱 그 뉘앙스다.
소프트웨어에서 회귀란 "예전에 멀쩡히 동작하던 기능이 어떤 변경 때문에 다시 나빠진 것"을 가리킨다. 결제가 잘 되던 서비스에 로그 한 줄을 추가했더니 결제가 깨졌다면, 결제 기능은 "회귀"한 것이다. 그래서 그런 후퇴가 일어났는지 확인하는 활동이 회귀 테스트다. 이름이 곧 정의다 — 새 기능이 잘 되는지를 보는 게 아니라, 되던 게 안 되게 됐는지를 본다.

다이어그램 설명. 이 그림이 보여주는 건 회귀라는 단어가 가리키는 딱 한 가지 사건이다. "기능 X가 정상 동작하던 상태"에서 출발해, 개발자가 기능 X와는 무관한 다른 부분을 고치는 변경을 넣는다. 그 변경의 부작용으로 기능 X가 깨지는데, 아무도 X를 건드린 적이 없으니 눈치채지 못하고 넘어간다. 이 "되던 것이 나빠진" 마지막 상태가 회귀다. 핵심은 고친 곳이 아니라 안 고친 곳에서 문제가 난다는 점이다 — 그래서 개발자가 스스로 확인하기 가장 어렵다. 새로 짠 코드는 당연히 눈여겨보지만, 손대지 않은 결제 경로를 굳이 다시 열어 볼 이유가 없기 때문이다.
회귀 테스트는 종류가 아니라 목적이다
여기서 가장 흔한 오해가 갈린다. 사람들은 테스트를 단위 테스트, 통합 테스트, 시스템 테스트처럼 범위로 나눈 뒤, 회귀 테스트를 그 옆에 나란히 놓인 또 하나의 종류로 생각한다. 하지만 회귀 테스트는 그 줄에 끼는 항목이 아니다. 그건 다른 축이다.
단위 테스트(함수 하나를 따로 검증), 통합 테스트(여러 모듈이 맞물려 도는지 검증), 시스템 테스트(사용자 시나리오 전체를 검증) — 이 셋은 "무엇을 얼마나 넓게 보느냐"는 범위의 축이다. 반면 회귀 테스트는 "무엇을 위해 그 테스트를 지금 다시 돌리느냐"는 목적의 축이다. 그래서 같은 단위 테스트가 처음 짤 때는 새 기능 검증용이었다가, 반년 뒤 다른 변경이 들어올 때 그대로 다시 돌리면 그 순간엔 회귀 테스트가 된다. 테스트 코드는 한 글자도 안 바뀌었는데 역할이 바뀐다.

다이어그램 설명. 이 그림은 "회귀 방지라는 하나의 목적"이 세 가지 범위의 테스트로 각각 실현되는 모습을 보여준다. 함수 단위든, 모듈이 맞물린 단위든, 사용자 시나리오 전체 단위든 — 어느 범위에서든 기존에 통과하던 테스트를 다시 돌려 여전히 통과하는지 확인하는 순간 그것은 회귀 테스트다. 그래서 "회귀 테스트 스위트"라는 건 물리적으로 따로 존재하는 별도의 테스트 뭉치가 아니라, 이미 있는 테스트들을 회귀 방지 목적으로 다시 돌리는 행위에 붙인 이름에 가깝다. 여기서 놓치기 쉬운 함정이 하나 있다 — "회귀 테스트를 새로 짜야 한다"고 생각하는 것이다. 대개는 새로 짜는 게 아니라, 기존 테스트를 버리지 않고 계속 다시 돌리기로 결정하는 것이 회귀 테스트의 시작이다.
목적 — 국소적 변경, 비국소적 파괴
그렇다면 왜 이런 테스트가 따로 필요할까. 답은 소프트웨어의 고약한 성질 하나에 있다. 변경은 국소적인데 그 영향은 비국소적이다. 코드 한 줄을 고치는 손은 파일 하나 안에 있지만, 그 한 줄이 부르는 파장은 코드베이스 전체로 퍼진다.
왜 그럴까. 코드는 공유하기 때문이다. 여러 기능이 같은 유틸리티 함수를 부르고, 같은 데이터베이스 테이블을 읽고, 같은 설정값을 참조하고, 같은 라이브러리 버전에 기대어 산다. 결제 로직의 반올림 오차를 고치려고 공유 계산 함수를 한 줄 바꾸면, 그 함수를 부르는 정산·환불·포인트 적립이 한꺼번에 흔들린다. 고친 사람의 머릿속엔 "결제"만 있었지만, 실제 영향 범위는 그 함수를 부르는 모든 곳이다. 이 어긋남 — 의도한 변경 범위와 실제 영향 범위 사이의 간극 — 이 바로 회귀가 태어나는 자리다.
개발자는 자기가 의도한 효과는 꼼꼼히 확인한다. 반올림이 제대로 고쳐졌는지 직접 눌러 본다. 하지만 의도하지 않은 부작용은 정의상 개발자의 시야 밖에 있다. 시야 밖에 있으니 손으로는 못 잡는다. 회귀 테스트는 바로 이 사각지대를 기계적으로 훑는 그물이다 — 사람의 주의가 미치지 않는 곳을, 기존에 통과하던 테스트를 전부 다시 돌려서 대신 지켜본다. 그래서 회귀 테스트의 자동화는 선택이 아니라 전제다. 변경 하나 넣을 때마다 수백 개 기능을 손으로 다시 눌러 볼 수는 없기 때문이다.
이 지점에서 나란히 헷갈리는 개념이 하나 있다. 버그를 고친 뒤에 하는 두 가지 확인은 목적이 전혀 다르다. 확인 테스트(confirmation testing 또는 re-testing)는 "내가 방금 고친 그 버그가 정말 사라졌는가"를 본다. 고친 자리를 정조준하는 것이다. 반면 회귀 테스트는 "그 수정 때문에 다른 멀쩡하던 것이 깨지지 않았는가"를 본다. 시선의 방향이 정반대다 — 하나는 고친 곳을 들여다보고, 하나는 안 고친 곳을 둘러본다. 둘 다 필요하고, 순서도 있다. 먼저 확인 테스트로 수정이 유효한지 보고, 그다음 회귀 테스트로 그 수정이 남긴 부작용이 없는지 훑는다. 이 둘을 뭉뚱그려 "테스트 다시 돌린다"로만 생각하면, 정작 회귀라는 사각지대가 있다는 사실 자체를 놓친다.
역할 — 배포 파이프라인의 승격 관문
지난 글에서 다룬 스테이징·프로덕션 파이프라인으로 돌아와 보자. 회귀 테스트는 그 흐름의 어디에 서 있을까. 대부분의 파이프라인에서 회귀 테스트는 "이 빌드를 다음 단계로 올려도 되는가"를 판정하는 승격 관문(promotion gate) 자리에 놓인다.

다이어그램 설명. 이 그림은 회귀 테스트가 배포 흐름의 어느 지점에서 문을 지키는지 보여준다. 변경을 담은 이미지를 빌드한 뒤, 스테이징에서 전체 테스트 스위트를 다시 돌리는 것 자체가 회귀 테스트다. "기존 기능이 전부 그대로 통과하는가?"라는 분기가 관문이다 — 통과하면 프로덕션으로 승격하고, 하나라도 실패하면 그것이 곧 회귀 발견이므로 승격을 막고 원인을 캔다. 흥미로운 건 프로덕션으로 올린 뒤에도 카나리에서 얕은 재확인이 한 번 더 붙는다는 점이다. 이건 중복이 아니다 — 앞 단계가 구조적으로 볼 수 없던 회귀가 있기 때문이다. 스테이징의 작은 데이터셋에서는 멀쩡하던 쿼리가 프로덕션의 대용량에서만 느려지는 경우처럼, "코드는 같은데 조건이 다르다"에서 나오는 회귀는 프로덕션 조건에 실제로 올려 봐야만 드러난다. 그래서 회귀 테스트는 한 곳이 아니라 여러 레벨에 겹겹이 놓인다.
여기서 현실적인 비용 문제가 생긴다. 변경이 있을 때마다 모든 테스트를 전부 다시 돌리는 방식(retest-all)은 가장 안전하지만 가장 비싸다. 실제로 회귀 테스트는 소프트웨어 유지보수 비용의 절반가량을 차지한다는 연구도 있을 만큼, 스위트가 커지면 한 번 도는 데 몇십 분에서 몇 시간이 걸린다. 그래서 실무에서는 세 가지 절충을 쓴다. 선택(selection)은 이번 변경과 관련된 테스트만 골라 돌리고, 우선순위화(prioritization)는 결함을 빨리 잡을 만한 테스트를 앞으로 당겨 배치하며, 최소화(minimization)는 중복되는 테스트를 스위트에서 걷어낸다. 전부 "안전은 지키되 다 돌리지는 않는" 타협이다. 작은 코드베이스나 최종 배포 직전에는 retest-all이 현실적이지만, 커밋마다 도는 CI에서는 선택·우선순위화가 사실상 필수다.
회귀 스위트는 설계되지 않는다 — 쌓인다
마지막으로, 회귀 테스트를 이해하는 데 가장 중요한데도 잘 이야기되지 않는 성질이 하나 있다. 좋은 회귀 스위트는 처음부터 설계해서 만드는 게 아니라, 사고를 겪을 때마다 한 겹씩 쌓여서 만들어진다.

다이어그램 설명. 이 흐름은 회귀 스위트가 자라는 방식을 보여준다. 프로덕션에서 사고가 터지면, 원인을 고치는 데서 끝내지 않고 그 사고를 정확히 재현하는 테스트를 하나 짜서 스위트에 영구히 넣는다. 그러면 다음에 누가 무슨 변경을 넣든, 그 테스트가 매번 다시 돌면서 같은 실수가 재발하는 순간 빨간불을 켠다. 이렇게 하면 "같은 회귀는 두 번 나지 않는다"가 보장된다. 이 패턴의 가치는 조직의 실패 경험이 코드로 굳어 축적된다는 데 있다. 한 번 아프게 배운 교훈이 사람의 기억에만 남으면 그 사람이 떠날 때 같이 사라지지만, 재현 테스트로 남으면 스위트가 그 기억을 대신 짊어진다. 그래서 오래된 프로젝트의 회귀 스위트를 읽으면, 마치 그 프로젝트가 겪어 온 사고의 연대기를 보는 것 같다 — 테스트 하나하나가 "예전에 여기서 한 번 데였다"는 흉터인 셈이다.
이 관점에서 보면 회귀 테스트를 대하는 자세가 달라진다. 버그를 고칠 때 "고쳤으니 끝"이 아니라 "이 버그가 다시는 못 들어오게 문을 하나 달았는가"를 묻게 된다. 개인 프로젝트에서도 마찬가지다. 직접 돌리는 서비스가 몇 개만 넘어가도, 한 곳을 고치다 다른 곳을 조용히 깨뜨리는 일이 반드시 생긴다. 그때마다 사고를 재현하는 테스트를 한 줄씩 남겨 두면, 스위트가 나 대신 그 사고를 기억해 준다.
정리 — 이름을 읽으면 목적이 보인다
회귀 테스트는 별도의 테스트 종류가 아니라 "되던 것이 나빠졌는지 지켜본다"는 목적에 붙은 이름이다. 그 목적은 단위·통합·시스템 어느 범위에서든 실현되고, 배포 파이프라인에서는 다음 단계로 올려도 되는지 판정하는 관문으로, 프로덕션에서는 조건이 달라져야만 드러나는 회귀를 잡는 얕은 그물로 겹겹이 선다. 그리고 그 스위트는 설계되는 게 아니라 사고를 겪을 때마다 한 겹씩 쌓인다.
그래서 다음에 버그를 하나 고칠 때, 고친 것으로 만족하지 말고 한 가지를 더 하면 좋겠다 — 그 버그를 재현하는 테스트를 한 줄 남겨, 같은 회귀가 두 번 들어올 문을 닫아 두는 것. 이름이 이미 말해 주듯, 회귀 테스트의 목적은 앞으로 나아가는 걸 확인하는 게 아니라 뒤로 미끄러지지 않게 붙드는 데 있다.
참고한 공개 자료:
- What is Regression Testing? — IBM
- Regression Testing — Purple Griffon (용어 유래)
- Regression testing minimization, selection and prioritization: a survey — Software Testing, Verification & Reliability
- A New Proposed Technique to Improve Software Regression Testing Cost (retest-all 비용)
- Regression Testing: A Guide for QA Teams — TestRail
이 글은 생성형 AI의 도움을 받아 작성되었습니다. 원본 자료를 기반으로 AI가 초안을 생성하고, 작성자가 검토·편집하였습니다.
'IT' 카테고리의 다른 글
graphify에 던진 질문은 어디로 가나 — MCP 질의가 지식을 뒤지는 방식과 그게 RAG인지 (0) 2026.10.07 graphify는 정말 LLM을 안 쓸까 — 소스를 열어 확인한 '코드냐 아니냐'의 경계선 (0) 2026.10.06 graphify는 언제 특히 쓸모 있나 — 코드 지식 그래프가 답하는 질문과 그게 가능한 원리 (0) 2026.10.05 Codebase-Memory가 코드를 인덱싱하는 법 — Tree-sitter 구문에서 해소된 호출 그래프까지 (0) 2026.10.04 지울까, AST로 남길까 — 모델이 코드를 읽는 시대의 what·how 문서화 (0) 2026.10.03 기능 플래그와 카오스 엔지니어링 — 끄는 스위치를 심고, 일부러 부러뜨려 본다 (1) 2026.10.01 서버가 둘이 되는 순간 로그인이 풀린다 — 세션은 그동안 어디에 살고 있었나 (0) 2026.09.30 테스트·스테이징·프로덕션에 같은 도커 이미지를 쓰는 게 맞을까 — '로컬에서 굽고 여기저기 올린다'가 어긋나는 지점 (0) 2026.09.29 MCP·RAG에 API를 넣기 전에 설명을 다듬어야 할까 — 모델이 똑똑해져도 남는 enrich의 이득, 사라지는 이득 (0) 2026.09.28 Gemini는 왜 OpenClaw의 OAuth 연동만 콕 집어 막았나 — 인증 토큰에 숨은 요금 계약 (0) 2026.09.27