-
MCP·RAG에 API를 넣기 전에 설명을 다듬어야 할까 — 모델이 똑똑해져도 남는 enrich의 이득, 사라지는 이득IT 2026. 9. 28. 21:00
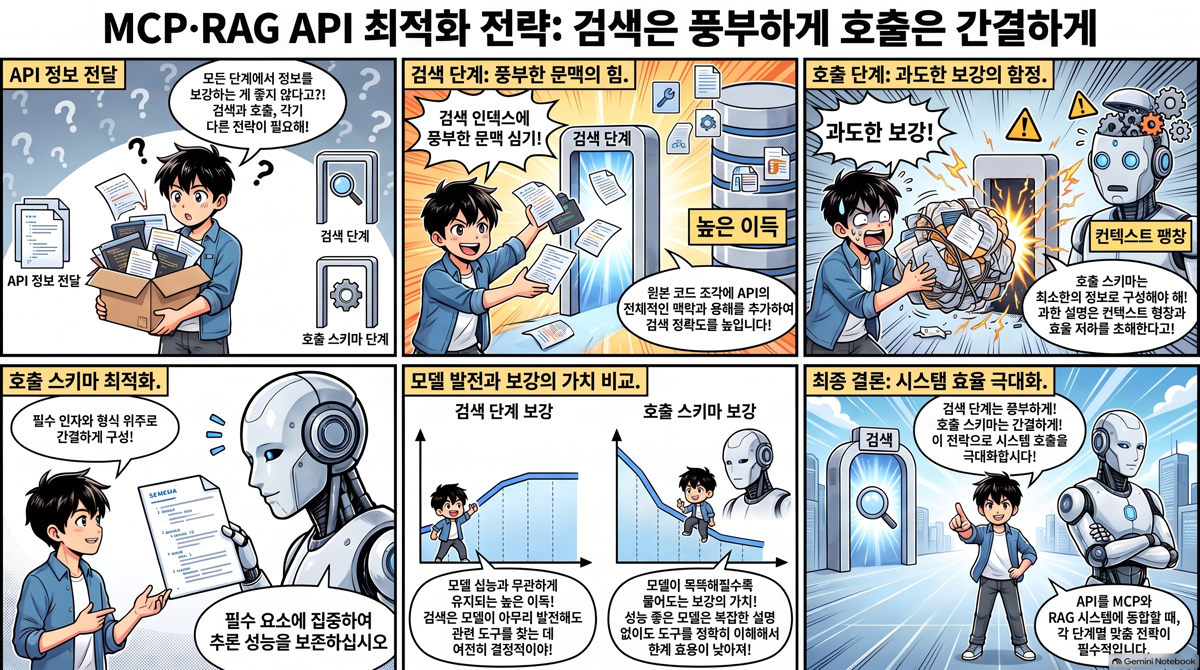
▶ 동영상 개요 — MCP·RAG에 API를 넣기 전에 설명을 다듬어야 할까 — 모델이 똑똑해져도 남는 enrich의 이득, 사라지는 이득
7분 35초 — API를 MCP·RAG에 넣을 때 enrich가 두 곳에서 다르게 작동한다 — 검색(찾기) 단계 enrich는 이득이 크고 모델 성능과 무관하게 남지만, 호출… — NotebookLM 동영상 개요로 생성 🎧 오디오 개요 — MCP·RAG에 API를 넣기 전에 설명을 다듬어야 할까 — 모델이 똑똑해져도 남는 enrich의 이득, 사라지는 이득
10분 48초 — API를 MCP·RAG에 넣을 때 enrich가 두 곳에서 다르게 작동한다 — 검색(찾기) 단계 enrich는 이득이 크고 모델 성능과 무관하게 남지만, 호출…. 화면은 이 글의 인포그래픽 한 장 고정 — NotebookLM 오디오 개요로 생성 코드 어시스턴트에 API를 도구로 노출하는 작업을 하면서 계속 걸리던 질문이 하나 있었다. 함수 시그니처와 설명, 그리고 샘플 코드를 있는 그대로 MCP 서버나 RAG 인덱스에 넣을 것인가, 아니면 한 번 다듬어서(enrich) 넣을 것인가? 여기서 enrich란 원문에 없던 문맥을 붙이는 일이다 — 이 함수가 어떤 상황에서 쓰이는지 한 줄 덧붙이고, 파라미터마다 설명을 채우고, 호출 예시를 하나 만들어 붙이는 식이다.
처음엔 답이 뻔해 보였다. 더 풍부하게 넣으면 당연히 낫겠지. 그런데 요즘 모델이 워낙 좋아져서, raw 시그니처만 던져 줘도 알아서 잘 읽는다.
bt_socket_connect_rfcomm(int socket_fd, const char *address)한 줄만 봐도 두 번째 인자가 주소라는 걸 모델이 파악한다. 그러면 enrich에 들이는 수고와 토큰이 아깝지 않나? 이 의문을 붙잡고 학계와 오픈 커뮤니티의 자료를 뒤졌더니, 답은 "효과 있다/없다"의 이분법이 아니었다. enrich가 어디에서 작동하는지를 먼저 나눠야 답이 갈렸다.enrich는 두 곳에서 작동한다 — 찾기와 호출
API 정보를 시스템에 넣으면 그 정보는 서로 다른 두 지점에서 쓰인다. 이걸 구분하지 않은 채 "enrich가 효과 있냐"를 물으면 대답이 엉킨다.

다이어그램 설명. 원본 API 정보가 두 갈래로 흘러 들어간다는 것을 보여준다. 한쪽은 "검색 인덱스에 저장"으로 가서, 나중에 사용자 질의가 들어왔을 때 어떤 도구·문서를 후보로 꺼낼지를 정한다. 다른 한쪽은 "도구 스키마로 등록"으로 가서, 후보가 컨텍스트에 올라온 뒤 모델이 인자를 어떻게 채워 호출할지를 정한다. 핵심은 이 둘이 전혀 다른 문제라는 점이다. 앞쪽은 "관련 있는 걸 못 찾으면 끝"인 검색 문제이고, 뒤쪽은 "찾긴 찾았는데 잘못 부른다"는 호출 문제다. enrich를 이 두 지점 중 어디에 거느냐에 따라 이득의 크기도, 모델이 좋아졌을 때 그 이득이 남느냐 사라지느냐도 달라진다.
찾기 쪽 — 이득이 크고, 모델 성능과 거의 무관하다
검색 단계에 문맥을 심는 enrich는 효과가 크고 뚜렷하다. 가장 잘 정리된 근거가 Anthropic이 2024년에 공개한 Contextual Retrieval이다. 보통의 RAG(Retrieval-Augmented Generation, 검색해 온 문서 조각을 프롬프트에 끼워 넣는 방식)는 문서를 조각(chunk)으로 잘라 그 조각만 임베딩한다. 문제는 조각 하나만 떼어 놓으면 "이 함수는 두 번째 인자로 타임아웃을 받는다" 같은 문장이 어느 함수 얘긴지 검색이 알 수 없다는 데 있다.
# 원본 조각: 이 문장만 임베딩하면 "이 함수"가 무엇인지 검색이 모른다
chunk = "이 함수는 두 번째 인자로 타임아웃(초)을 받는다."

# enrich: LLM이 문서 전체를 보고 조각의 자리를 한 줄로 붙인다 (50~100토큰)
context = "이 절은 bt_socket_connect_rfcomm() API의 파라미터를 설명한다."
enriched = context + "\n" + chunk   # 이 합본을 임베딩·색인한다

# 질의 "블루투스 소켓 연결 타임아웃"이 들어오면
# 원본만 색인했을 때보다 이 조각이 검색 상위로 올라온다
코드 설명. enrich의 정체를 가장 작게 줄이면 이 세 줄이다. 원본 조각 앞에 "이 조각이 문서 어디에 속하는지"를 한 줄(50~100토큰) 붙여서, 그 합본을 임베딩·색인한다. Anthropic은 이 한 줄을 값싼 소형 모델(Claude 3 Haiku)로 자동 생성했고, 프롬프트 캐싱을 쓰면 문서 100만 토큰당 1.02달러라는 일회성 비용으로 전체 문서를 전처리할 수 있었다. 놓치기 쉬운 함정은 이 문맥이 모델에게 보여주려는 게 아니라 임베딩 벡터에 심으려는 것이라는 점이다 — 검색이 더 잘 걸리게 하는 신호이지, 답변 품질을 직접 손대는 게 아니다.
수치가 이 방향을 분명히 못 박는다. Anthropic 보고에 따르면, 조각마다 문맥을 붙인 것만으로 상위 20개 검색 실패율이 5.7%에서 3.7%로 35% 줄었고, 여기에 키워드 매칭(BM25, 정확한 단어·구문 일치를 점수화하는 고전 검색 함수)을 함께 쓰자 2.9%까지 49% 감소했다. 재순위(reranking)까지 얹으면 1.9%로 전체 67%가 줄었다. AWS가 Bedrock에서 같은 기법을 재현했을 때도 데이터셋 전반에서 검색 정밀도가 5~15% 올랐다. 도구 검색에 특화한 연구들도 같은 결론이다 — 도구 설명을 잘 정의된 필드로 체계적으로 보강하면 랭킹 지표(NDCG@10, Recall@10)가 6~7%포인트 올랐다는 보고가 있고, EasyTool처럼 LLM으로 도구 설명의 중복·불일치·누락을 다듬어 검색 성능을 끌어올린 사례도 있다.
여기서 중요한 사실이 하나 있다. 이 이득은 답변을 생성하는 모델이 아무리 똑똑해져도 거의 그대로 남는다. 검색은 생성 이전 단계이기 때문이다. 임베딩 모델이 관련 조각을 못 꺼내 오면, 그 뒤에 붙은 생성 모델이 GPT든 최신 Claude든 아무 소용이 없다 — 못 받은 정보로는 답할 수 없다. "모델이 좋아졌으니 raw로 충분하다"는 직관이 여기서는 통하지 않는다.
호출 쪽 — 모델이 좋아질수록 이득이 줄어든다
반대로 "찾은 도구를 정확히 호출하게" 돕는 enrich는 이야기가 다르다. 여기가 바로 사용자의 직관 — "요즘 모델은 raw만 봐도 잘 부른다" — 이 실제로 들어맞는 지점이다. 2025년에 나온 엔터프라이즈 API 도구화 연구가 이 부분을 정면으로 다뤘다. 이들은 API 문서에 세 가지를 보강했다. 정형화된 시그니처, 최소 문서를 넘어서는 상세 설명, 그리고 구체적인 호출 예시다. 특히 요청 본문(request body) 예시를 넣자 파라미터 누락 오류가 확연히 줄었다.
그런데 이 연구의 결론이 사용자의 질문에 대한 가장 정확한 답이다. 작은 모델은 enrich에서 큰 이득을 보지만, 큰 모델은 최소한의 문서만으로도 견고하게 동작했다. 즉 enrich는 성능이 제한된 모델에게는 결정적인 발판이지만, 이해력이 강한 상위 모델에게는 점점 부수적인 이득으로 수렴한다. Gorilla가 검색해 온 API 문서를 프롬프트에 직접 붙여 호출 정확도를 끌어올린 것도 같은 맥락인데, 모델이 자체적으로 API 형태를 더 잘 추론할수록 그 발판의 한계효용은 줄어든다.

다이어그램 설명. 같은 API 정보라도 "무엇을 도우려는가"라는 갈림길에서 답이 둘로 나뉜다는 것을 보여준다. "올바른 후보를 찾게 하기"로 가면 검색 단계에 문맥을 심는 쪽이고, 그 이득은 크며 생성 모델 성능과 거의 무관하게 남는다. "찾은 도구를 정확히 호출"로 가면 호출 스키마를 최소·정확하게 유지하는 쪽이고, 이쪽 이득은 모델이 좋아질수록 줄어든다. 이 그림이 주는 실용적 결론은 명확하다 — enrich 예산이 한정돼 있다면 검색 쪽에 먼저 쓰고, 호출 스키마는 필수 인자와 형식만 남겨 담백하게 두는 편이 낫다. 상위 모델은 호출 쪽 장식을 갈수록 덜 필요로 하기 때문이다.
그런데 무작정 enrich하면 오히려 나빠진다 — 컨텍스트 팽창
더 중요한 반대 힘이 있다. 호출 스키마 쪽 enrich는 한계효용이 줄기만 하는 게 아니라, 과하면 마이너스가 된다. 이유는 토큰이다. 모델 컨텍스트에 올라가는 도구 정의는 공짜가 아니다. 커뮤니티 보고를 보면 도구 메타데이터가 가용 컨텍스트의 40~50%를 잡아먹고, MCP 서버 하나가 도구 정의만으로 4만 2천 토큰을 쓰는 경우도 있다. 서버 네다섯 개를 겹치면 6만 토큰이 스키마로만 날아간다.
이게 왜 문제인가? 첫째, 모델이 넓은 토큰을 가로질러 주의를 분산하면 정작 지금 할 일의 신호가 불필요한 정의의 잡음에 묻힌다 — 긴 컨텍스트의 중간부에서 정확도가 떨어지는 "lost in the middle" 현상이다. 둘째, 후보 도구가 늘수록 모델이 더 나쁜 도구를 고른다. 이건 완만한 저하가 아니라 절벽이라, 대략 도구 20개를 넘어서면 급격히 무너진다는 관측이 반복된다.
그래서 현장은 정반대로 움직이고 있다. GitHub Copilot은 도구를 40개에서 13개로 줄여 벤치마크가 오히려 좋아졌고, Block은 특정 서비스의 MCP 서버를 30개가 넘는 도구에서 단 2개로 재설계했다. 업계 경험칙은 한 번에 도구 10~15개, 연결 서버 5~7개를 상한으로 본다. "더 풍부하게, 더 많이"가 어느 지점을 넘으면 도구 선택 정확도와 응답 품질을 동시에 떨어뜨린다는 뜻이다.
축 검색 쪽 enrich (찾기) 호출 스키마 enrich (부르기) 목적 올바른 도구·문서를 후보로 꺼내기 꺼낸 도구를 정확히 호출하기 이득 크기 큼 (실패율 35~67% 감소 보고) 모델에 따라 다름 모델이 좋아지면 이득 거의 그대로 유지 한계효용 감소, 과하면 역효과 토큰 비용 임베딩 전처리 비용 (일회성, 저렴) 매 호출 컨텍스트 상주 (지속적) 권장 문맥·동의어·용례를 넉넉히 심기 필수 인자·형식만 담백하게 표 설명. 두 종류의 enrich를 같은 축에서 나란히 놓은 것이다. 눈여겨볼 대비는 "토큰 비용" 줄이다. 검색 쪽 문맥은 임베딩할 때 한 번만 값을 치르고 벡터에 녹아들지만, 호출 스키마는 도구가 후보로 오를 때마다 매번 컨텍스트에 올라가 지속적으로 비용을 문다. 이 비대칭 때문에 "검색엔 넉넉히, 호출엔 담백하게"라는 서로 다른 처방이 나온다.
정리 — enrich를 "설명 부풀리기"가 아니라 "찾기 신호"로 본다
처음 질문으로 돌아가자. "enrich가 정말 효과가 있나, 모델이 좋아졌으니 raw가 낫지 않나." 자료를 다 보고 나서 내가 내린 답은 이렇다. enrich를 "모델에게 더 친절한 설명을 붙이는 일"로 이해하는 한, 모델이 좋아질수록 그 수고는 점점 덜 남는다. 상위 모델은 담백한 시그니처만으로도 잘 부르고, 오히려 과한 설명은 컨텍스트를 팽창시켜 도구 선택을 망친다. 사용자의 직관은 이 절반에서 옳다.
하지만 enrich를 "검색이 올바른 후보를 꺼내도록 신호를 심는 일"로 이해하면, 그 이득은 모델 세대가 바뀌어도 그대로 남는다. 생성 모델이 아무리 똑똑해도 못 받은 정보로는 답하지 못하고, 검색은 생성 이전의 관문이기 때문이다. 그러니 실무 결론은 두 갈래로 갈린다 — 검색 인덱스에는 문맥과 용례를 넉넉히 심되, 모델이 매번 읽는 호출 스키마는 필수만 남겨 최소로 유지한다. 내 작업에도 이 원칙을 그대로 적용하기로 했다. 다듬는 노력을 도구 정의를 부풀리는 데 쓰지 않고, 그 도구가 검색에 잘 걸리도록 주변 문맥을 심는 데 쓴다.
참고한 공개 자료:
- Anthropic — Introducing Contextual Retrieval: anthropic.com/engineering/contextual-retrieval
- AWS — Contextual retrieval in Anthropic using Amazon Bedrock Knowledge Bases: aws.amazon.com
- Automated Creation and Enrichment Framework for Improved Invocation of Enterprise APIs as Tools (arXiv:2509.11626): arxiv.org/abs/2509.11626
- Gorilla: Large Language Model Connected with Massive APIs (arXiv:2305.15334): arxiv.org/abs/2305.15334
- EasyTool: Enhancing LLM-based Agents with Concise Tool Instruction (arXiv:2401.06201): arxiv.org/abs/2401.06201
- The New Stack — 10 strategies to reduce MCP token bloat: thenewstack.io
- Atlassian — MCP Compression: Preventing tool bloat in AI agents: atlassian.com
이 글은 생성형 AI의 도움을 받아 작성되었습니다. 원본 자료를 기반으로 AI가 초안을 생성하고, 작성자가 검토·편집하였습니다.
'IT' 카테고리의 다른 글
Gemini는 왜 OpenClaw의 OAuth 연동만 콕 집어 막았나 — 인증 토큰에 숨은 요금 계약 (0) 2026.09.27 DeepWiki는 이제 필요 없을까 — 모델이 코드를 읽는 시대의 문서화 (0) 2026.09.26 Kimi K2는 정말 오푸스·소네트와 붙나 — 1조 개 중 320억만 켜는 오픈 웨이트 모델의 정체 (0) 2026.09.25 GLM-5.3은 왜 갑자기 오푸스와 붙나 — 뼈대는 그대로 두고 후처리만 갈아 끼운 오픈 웨이트 모델 (0) 2026.09.24 나머지를 다 고정하고 내 것만 빠르게 — 그게 fixture인가, 최선인가 (0) 2026.09.23 합성 모니터링 — 아무도 안 쓰는 새벽 3시에 로그인·결제를 대신 밟아 주는 로봇 (0) 2026.09.22 카나리 릴리스 — 새 버전을 사용자 1%에게만 먼저 흘려보내고 지표로 판정한다 (0) 2026.09.22 스모크 테스트 — 배포 직후 '불이 켜지긴 하나'만 60초에 확인하는 얕고 빠른 그물 (0) 2026.09.22 테스트는 레벨마다 다른 질문에 답한다 — 로컬·통합·프로덕션에서 공통 테스트를 반복해야 할까 (0) 2026.09.22 Acorn은 플러그인도 테마도 아니다 — 워드프레스 안에 라라벨을 심는 물건의 정체와 2026년 현황 (0) 2026.09.21