-
graphify가 LLM에게 건네는 단어 12개 — 코드 덩어리에 이름을 붙이는 '증거 풀'의 정체IT 2026. 10. 11. 23:00
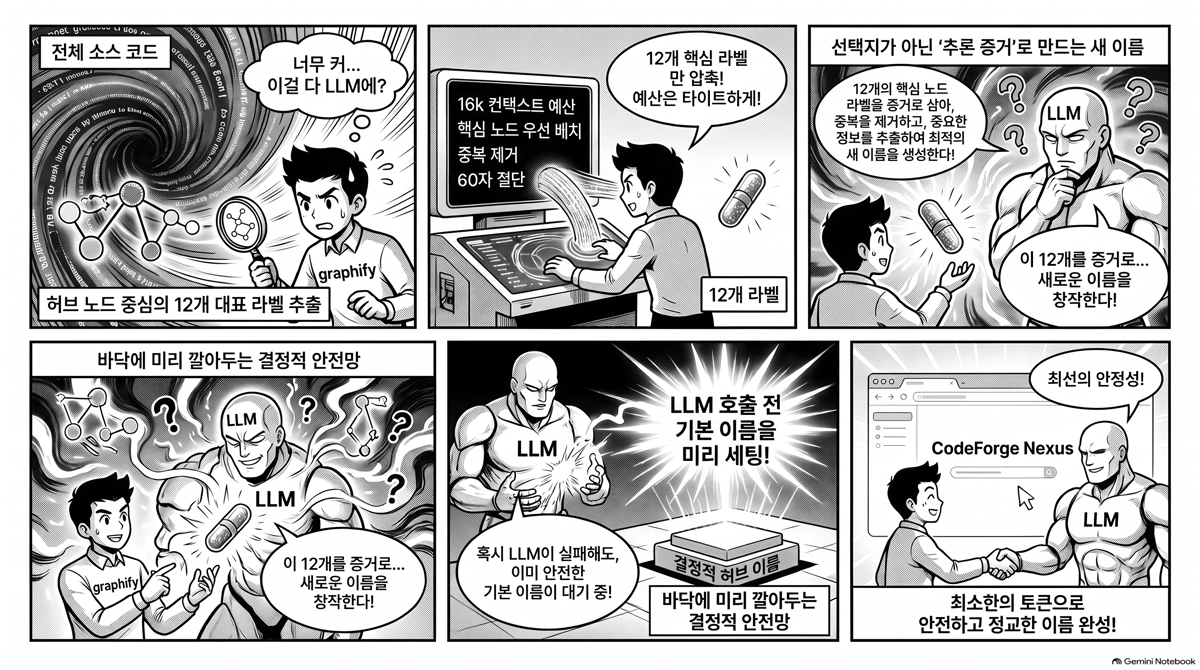
▶ 동영상 개요 — graphify가 LLM에게 건네는 단어 12개 — 코드 덩어리에 이름을 붙이는 '증거 풀'의 정체
8분 34초 — graphify가 코드 커뮤니티에 이름을 붙일 때 LLM에게 건네는 대표 라벨 최대 12개 — 허브 노드 먼저·중복 제거·60자 절단으로 추려 16k 컨텍스트… — NotebookLM 동영상 개요로 생성 🎧 오디오 개요 — graphify가 LLM에게 건네는 단어 12개 — 코드 덩어리에 이름을 붙이는 '증거 풀'의 정체
25분 58초 — graphify가 코드 커뮤니티에 이름을 붙일 때 LLM에게 건네는 대표 라벨 최대 12개 — 허브 노드 먼저·중복 제거·60자 절단으로 추려 16k 컨텍스트…. 화면은 이 글의 인포그래픽 한 장 고정 — NotebookLM 오디오 개요로 생성 코딩 에이전트가 쓰는 도구의 속을 또 들여다보다, 이번엔 숫자 하나에 걸려 멈췄다. 소스 한가운데에
_LABEL_TOP_K = 12라는 상수가 박혀 있고, 주석엔 "프롬프트에 넣을 커뮤니티당 노드 라벨 샘플 수"라고 적혀 있었다. 그러니까 graphify는 코드를 분석한 뒤 어느 시점에 LLM에게 단어 12개를 건넨다는 뜻이다. 왜 하필 12개이고, 그 12개는 어떻게 골라지며, 받은 LLM은 그걸로 무엇을 하는 걸까?graphify는 코드베이스를 함수·클래스 단위 지식 그래프로 바꿔 주는 Apache-2.0 오픈소스다(YC S26, PyPI 패키지명
graphifyy, 분석 시점 버전 v0.9.37). 코드는 tree-sitter AST(소스를 구문 단위로 파싱한 결정적 트리)로만 읽어 LLM도 임베딩도 쓰지 않는 것으로 알려져 있다. 그래서 더 궁금했다. 코드 분석은 전부 결정적이라면서, 왜 갑자기 LLM에게 단어 묶음을 넘기는 자리가 있을까. 따라가 보니 그 자리는 딱 하나, 코드 덩어리에 사람이 읽을 이름을 붙이는 순간이었다.수백 개의 덩어리에 이름을 붙이는 문제
graphify는 코드를 그래프로 바꾸고 나면 그 그래프를 커뮤니티(community) 단위로 묶는다. 커뮤니티란 서로 연결이 촘촘한 노드 무리를 말한다 — 인증 관련 함수들끼리, 결제 관련 클래스들끼리 자연스럽게 뭉치는 덩어리다. 이 묶음을 찾는 데는 Leiden 알고리즘(그래프를 모듈성 기준으로 잘게 나누는 군집화 기법, 없으면 Louvain으로 대체)을 쓴다. 문제는 그다음이다. 1만 개짜리 그래프를 묶으면 커뮤니티가 수백 개 나오는데, 이것들을 사람이 읽는 리포트로 내려면 각 덩어리에 이름이 필요하다. 그냥 두면 "Community 70", "Community 118" 같은 번호뿐이라 아무 의미가 없다.

다이어그램 설명. 소스 코드가 이름 붙은 덩어리가 되기까지의 전체 흐름이다. "소스 코드"가 "함수·클래스 그래프"로 파싱되는 단계까지는 LLM이 전혀 개입하지 않는 결정적 과정이고, "커뮤니티 탐지"도 순수 그래프 알고리즘이다. LLM이 처음으로 등장하는 곳은 "대표 라벨 최대 12개 샘플링" 다음, 그 12개를 받아 "2~5단어 이름"을 돌려주는 단계 하나뿐이다. 핵심은 이것이다 — graphify는 코드를 LLM에게 읽히지 않는다. LLM에게 보여 주는 건 이미 다 만들어 둔 그래프에서 추려 낸 단어 몇 개일 뿐이고, 그마저 "이름이나 붙여 달라"는 가장 가벼운 심부름이다.
여기서 사용자가 흔히 오해하는 지점이 있다. "LLM으로부터 요청을 받아 단어 풀을 준다"고 생각하기 쉽지만, 방향은 반대다. 요청을 보내는 쪽은 graphify이고, LLM은 그 요청을 받는 쪽이다. graphify가 "이 덩어리는 이런 단어들로 이뤄졌는데, 뭐라고 부르면 좋겠냐"고 묻고, LLM이 답한다. 이 방향을 잡아 두면 나머지가 전부 자연스럽게 읽힌다.
12개를 고르는 기준 — 중요한 것부터, 겹치지 않게
그럼 한 커뮤니티에 노드가 300개 있으면 그중 어떤 12개를 뽑을까? graphify는 아무거나 12개를 집지 않는다. 허브 노드(가장 많이 연결된 핵심 노드)를 맨 앞에 세우고 나머지를 뒤로 돌린 다음, 앞에서부터 중복을 걷어내며 12개를 채운다. 허브 노드란 그 코드베이스에서 호출선이 가장 많이 몰린 함수·클래스다 — 소스에서는 이를 재미있게도 "god node"라 부르는데, 파일 단위 노드는 import 관계로 기계적으로 연결이 많아지므로 제외하고 실제 추상만 센다.
# 커뮤니티 하나 → 프롬프트 한 줄. 큰 커뮤니티부터 처리한다.
for cid, members in ordered[:max_communities]:
    # 허브 노드(연결 많은 핵심 노드)를 앞으로, 나머지를 뒤로 정렬
    ranked = [m for m in members if m in god_set] + \
             [m for m in members if m not in god_set]
    names, seen = [], set()
    for nid in ranked:
        label = str(G.nodes[nid].get("label", nid)).strip().strip("()")[:60]
        if label and label.lower() not in seen:   # 소문자 기준 중복 제거
            seen.add(label.lower())
            names.append(label)
        if len(names) >= top_k:                    # top_k = 12, 여기서 끊는다
            break
    lines.append(f"{cid}: {', '.join(names)}")      # "70: auth, login, verify_token, …"
코드 설명. 한 커뮤니티를 프롬프트 한 줄로 압축하는 과정이다. 가장 먼저 멤버를 허브 먼저·나머지 나중 순서로 재정렬하고, 앞에서부터 라벨을 긁어 담되 소문자로 바꿔 이미 본 것이면 건너뛴다. 각 라벨은 60자에서 잘라 프롬프트가 비대해지지 않게 하고, 담은 개수가 12에 닿으면 즉시 멈춘다. 결과는
"70: auth, login, verify_token, …"같은 한 줄이다. 설계 의도가 선명하다 — 읽을 수 있는 단어가 12개뿐이라면 가장 신호가 센 것부터 읽어야 한다. 허브를 앞에 세우는 이유가 그것이다. 300개 중 아무 12개가 아니라, 그 덩어리의 정체를 가장 잘 대변하는 12개를 앞줄에 배치해 LLM이 헷갈릴 여지를 줄인다. 60자 절단과 중복 제거는 같은 이름이 열 번 반복돼 12칸을 낭비하는 일을 막는 자잘하지만 중요한 방어다.왜 12였을까. 소스의 다른 상수들이 답을 준다. 커뮤니티는 한 번에 100개씩 묶어 LLM을 호출하도록 돼 있는데(
_LABEL_BATCH_SIZE = 100), 주석엔 "16k 토큰 컨텍스트 창에 맞춰 잡은 크기"라고 적혀 있다. 커뮤니티 100개 × 라벨 12개 × 라벨당 최대 60자 — 이 곱이 16k 토큰 안에 들어오도록 역산한 숫자가 12다. 다시 말해 12는 품질 상수가 아니라 예산 상수다. 더 많이 보여 주면 이름이 더 좋아질 수야 있겠지만, 그만큼 한 번에 처리할 커뮤니티 수가 줄어 호출 횟수와 비용이 늘어난다. 12는 "덩어리 하나를 알아보기엔 충분하되 예산은 아끼는" 저울의 눈금이다."고른다"는 착각 — 메뉴가 아니라 증거다
여기서 가장 흔한 오해를 짚어야 한다. "12개 중에서 선택할 수 있는 단어 풀"이라는 표현은, LLM이 그 12개 중 하나를 집어 든다는 그림을 떠올리게 한다. 그런데 실제로는 그렇지 않다. graphify가 LLM에게 보내는 프롬프트를 보면 금방 드러난다.
# graphify가 LLM에게 실제로 보내는 프롬프트 (batch_lines = 위에서 만든 줄들)
prompt = (
    "You are naming clusters in a knowledge graph. For each community below, "
    "return a concise 2-5 word plain-language name describing what it is about "
    '(e.g. "Order Management", "Payment Flow", "Auth Middleware"). '
    "Each input line is '<community id>: <representative member names>'. "
    "Respond ONLY with a JSON object mapping the community id (as a string) to "
    "its name - no prose, no markdown fences.\n\n" + "\n".join(batch_lines)
)
코드 설명. 프롬프트의 핵심 지시는 "2~5단어로 된, 이 덩어리가 무엇에 관한 것인지 설명하는 평이한 이름을 지어라"이다. 예시로 제시된 "Order Management", "Payment Flow", "Auth Middleware"는 전부 입력 단어 목록에 없을 수 있는 말이다. LLM은
auth, login, verify_token, session, oauth같은 12개를 받아 "Auth Middleware"라는, 그 목록엔 한 번도 등장하지 않은 이름을 만들어 낸다. 즉 12개는 보기 메뉴가 아니라 추론의 증거다. LLM은 증거를 읽고 공통 주제를 짐작해 새 이름을 짓는다. 마지막 줄의 "오직 JSON 객체로만, 산문도 마크다운 울타리도 없이"라는 못은, 수백 개 커뮤니티의 답을 기계가 되받아 파싱할 수 있게 형식을 강제하는 장치다.이 "짓는다 vs 고른다"의 차이는 graphify 안에 실제로 두 가지 구현으로 공존한다. LLM이 없을 때 쓰는 결정적 기본 라벨러는 정말로 하나를 고르고, LLM 라벨러는 지어낸다. 두 방식을 나란히 놓으면 차이가 분명해진다.

▲ 방식 하나 — LLM 없는 결정적 라벨러
다이어그램 설명. 백엔드가 설정되지 않았을 때 graphify가 쓰는 기본 이름표다. 커뮤니티 멤버 중 연결이 가장 많은 노드 하나를 뽑아(동점이면 노드 id 순으로 갈라 매번 같은 결과가 나오게 한다), 그 노드의 라벨을 글자 그대로 이름으로 쓴다. 그래서 이름은 반드시 멤버 중 하나의 실제 이름, 예컨대
log_action같은 것이 된다. 장점은 공짜이고 결정적이라는 것, 한계는 그 이름이 덩어리 전체가 아니라 대표 노드 하나만 가리킨다는 것이다.
▲ 방식 둘 — LLM 라벨러
다이어그램 설명. 백엔드가 있을 때의 이름표다. 라벨 12개가 통째로 LLM에게 증거로 들어가고, LLM은 그 공통점을 읽어
Auth Middleware처럼 목록에 없던 새 이름을 만든다. 결정적 방식이 "대표 한 명의 이름"이라면, 이쪽은 "열두 명을 보고 붙인 모둠 이름"이다. 두 다이어그램을 견주면 같은 재료(커뮤니티 멤버)를 두고 한쪽은 선택, 다른 쪽은 종합으로 갈린다는 게 드러난다. 그래서 "단어 풀에서 고른다"는 말은 결정적 라벨러엔 맞지만 LLM 라벨러엔 틀리다. LLM에게 12개는 고를 메뉴가 아니라, 정답을 추론할 단서다.이름은 반드시 남는다 — 무너져도 바닥이 있다
LLM을 부르는 순간 불확실성이 끼어든다. 백엔드가 아예 없을 수도 있고, 모델이 JSON을 깨뜨릴 수도 있고, 토큰 예산이 모자라 답이 중간에 잘릴 수도 있다. graphify의 이름 붙이기가 흥미로운 건 이 모든 실패에 대해 이름이 비는 경우를 허용하지 않는다는 점이다. LLM 호출은 '덮어쓰기'일 뿐, 바닥에는 늘 결정적 이름이 먼저 깔린다.

다이어그램 설명. 이름 붙이기의 실패 대비 사다리다. 맨 처음 모든 커뮤니티에 허브 이름(연결 많은 노드의 라벨)이 결정적으로 먼저 깔린다는 게 출발점이다. 백엔드가 없으면 그대로 멈춰 허브 이름을 쓰고, 있으면 12개 풀을 보낸다. 돌아온 답이 JSON으로 읽히면 — 그것도 "진짜 이름일 때만" — 허브 이름 위에 덮어쓴다. 읽히지 않으면 묶음을 반으로 쪼개 다시 시도한다. 작은 묶음일수록 답이 짧아져 잘릴 확률이 낮아지기 때문인데, 그렇게 쪼개도 끝내 실패하면 그 묶음만 조용히 허브 이름을 유지하고 넘어간다. 한 묶음의 실패가 다른 묶음의 이름까지 날리지 않는다는 게 이 구조의 핵심이다.
디테일은 더 깐깐하다. 모델이 답을 중간에 끊어 먹어 JSON이 깨져도, graphify는 정규식으로 온전하게 도착한 "번호: 이름" 짝만 건져 그만큼이라도 이름을 붙인다 — 묶음 전체를 버리지 않는다. 또 하나, 모델이 게을러서 커뮤니티 번호를 그대로 이름 자리에 되돌려 주는 경우(5번 커뮤니티에 이름으로 "5"를 주는 식)가 있는데, 이건 이름이 아니라 번호이므로 거부하고 허브 이름을 지킨다. 심지어 LLM 라벨러가 내부적으로 "Community 70" 같은 자리표시자를 돌려줘도 그것으로는 결코 허브 이름을 덮지 못하게 막아 둔다. 요약하면 — LLM이 더 나은 이름을 주면 받고, 못 주면 결정적 이름이 그 자리를 지킨다.
이 설계가 왜 중요한가? graphify의 철학은 "답을 지어내지 않는다", 즉 확실하지 않은 것을 확실한 척 내놓지 않는 것이다. 그런데 이름 붙이기는 그 철학과 정면으로 부딪히는 자리다 — 이름을 짓는 건 본질적으로 LLM이 "추론해 지어내는" 일이니까. graphify는 이 긴장을 LLM의 창의는 위층에, 결정적 사실은 바닥층에 두는 2단 구조로 푼다. LLM이 좋은 이름을 지으면 읽기 좋은 리포트가 나오고, LLM이 실패하거나 아예 없어도 리포트는 "log_action", "auth" 같은 실제 코드 이름으로 여전히 읽힌다. 환각이 섞이더라도 그건 "덧칠"일 뿐, 바닥의 사실을 지우지 못한다.
정리 — 12개는 '신뢰의 크기'다
graphify가 LLM에게 건네는 단어 12개를 끝까지 따라가 보니, 그건 단순한 입력값이 아니라 설계 전체의 축소판이었다. 코드는 결정적으로 읽어 그래프로 만들고(LLM 손 안 탐), 그 그래프에서 가장 신호가 센 라벨을 추려(허브 먼저·중복 제거·60자 절단) 딱 예산만큼인 12개만 LLM에게 넘긴다. LLM은 그 12개 중 하나를 고르는 게 아니라 12개를 증거 삼아 새 이름을 짓고, 그 이름이 쓸 만할 때만 바닥에 깔린 결정적 이름을 덮어쓴다. 실패하면 바닥이 받친다.
여기서 가져갈 교훈은 분명하다. LLM에게 일을 시킬 때 핵심 질문은 "얼마나 많이 보여 줄까"가 아니라 "얼마나 적게 보여 줘도 일이 되는가, 그리고 그 일이 틀어졌을 때 무엇이 받치는가"이다. graphify는 코드 전체 대신 단어 12개를 보내 비용을 줄였고, 그마저 실패할 자리에 결정적 바닥을 깔아 신뢰를 지켰다. 내가 LLM을 끼운 파이프라인을 짤 때도 똑같이 물어볼 참이다 — 모델에게 넘기는 증거를 더 작게 추릴 수 있는가, 그리고 모델이 아무 답도 못 줄 때 사용자가 볼 화면에는 무엇이 남는가?
참고한 공개 자료:
- graphify 소스 저장소 — github.com/Graphify-Labs/graphify (커뮤니티 라벨링 로직은
graphify/llm.py, 결정적 허브 라벨러는graphify/cluster.py, 허브 노드 정의는graphify/analyze.py; 분석 버전 v0.9.37, Apache-2.0) - Leiden 커뮤니티 탐지 알고리즘 — Leiden community detection (Memgraph 문서)
- LLM으로 그래프 커뮤니티를 요약·명명하는 패턴의 선행 사례 — Microsoft GraphRAG (community reports)
- 코드 지식 그래프 도구 비교 — Code Knowledge Graphs: Graphify vs CodeGraph vs GitNexus
이 글은 생성형 AI의 도움을 받아 작성되었습니다. 원본 자료를 기반으로 AI가 초안을 생성하고, 작성자가 검토·편집하였습니다.
'IT' 카테고리의 다른 글
Leiden 알고리즘 — Louvain이 남긴 '끊어진 모듈'을 정제 한 칸으로 막는 법 (0) 2026.10.16 QA팀은 테스트하는 사람이 아니다 — AI가 테스트를 써 주는 시대에 드러나는 품질 보증의 진짜 일 (0) 2026.10.15 AI와 짝코딩하며 '검증했다'고 할 때, 그 검증은 무엇인가 — verification·validation·테스트, 그리고 누가 확인하는가 (0) 2026.10.14 Louvain 클러스터링 — 함수 수천 개를 사람 손 없이 모듈로 묶는 2008년생 알고리즘 (0) 2026.10.13 BM25는 왜 아직도 AI 에이전트의 RAG에 박혀 있나 — 1994년 검색 공식과 임베딩의 상반된 맹점 (0) 2026.10.12 graphify엔 한국어 불용어가 없다 — 그런데 왜 한국 사용자는 큰 불편 없이 쓰고 있을까 (0) 2026.10.10 graphify의 씨앗을 고르는 저울, TF-IDF — 쉰 살 먹은 검색 공식이 임베딩 시대에도 코드에선 더 세지는 이유 (1) 2026.10.09 세션과 토큰 — 로그인은 왜 이렇게 복잡한 기술이 되었나 (0) 2026.10.08 graphify에 던진 질문은 어디로 가나 — MCP 질의가 지식을 뒤지는 방식과 그게 RAG인지 (0) 2026.10.07 graphify는 정말 LLM을 안 쓸까 — 소스를 열어 확인한 '코드냐 아니냐'의 경계선 (0) 2026.10.06 - graphify 소스 저장소 — github.com/Graphify-Labs/graphify (커뮤니티 라벨링 로직은