-
QA팀은 테스트하는 사람이 아니다 — AI가 테스트를 써 주는 시대에 드러나는 품질 보증의 진짜 일IT 2026. 10. 15. 23:00
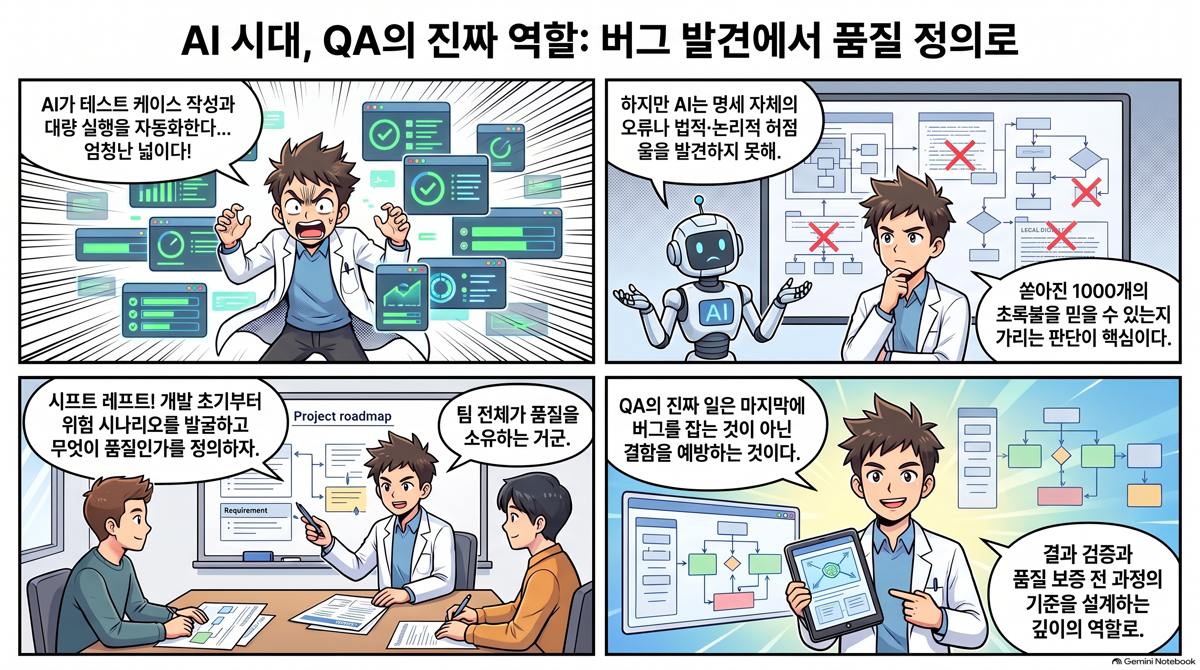
▶ 동영상 개요 — QA팀은 테스트하는 사람이 아니다 — AI가 테스트를 써 주는 시대에 드러나는 품질 보증의 진짜 일
9분 23초 — QA의 본래 일은 버그 '발견'이 아니라 '무엇이 품질인가'를 정의하고 지키는 과정이다. AI가 테스트 생성·실행이라는 '넓이'를 자동화할수록, '이 결과가 정… — NotebookLM 동영상 개요로 생성 🎧 오디오 개요 — QA팀은 테스트하는 사람이 아니다 — AI가 테스트를 써 주는 시대에 드러나는 품질 보증의 진짜 일
17분 2초 — QA의 본래 일은 버그 '발견'이 아니라 '무엇이 품질인가'를 정의하고 지키는 과정이다. AI가 테스트 생성·실행이라는 '넓이'를 자동화할수록, '이 결과가 정…. 화면은 이 글의 인포그래픽 한 장 고정 — NotebookLM 오디오 개요로 생성 개인 프로젝트 여러 개에 커밋 직전 자동 관문을 걸어 두고 한참을 지냈다. 테스트가 돌고, 타입이 맞는지 검사하고, 코드 커버리지가 정해 둔 선 아래로 떨어지지 않았는지 보고, 보안 취약점까지 스캔한 다음에야 변경이 통과된다. 하나라도 걸리면 커밋 자체가 막힌다. 어느 순간부터 내가 눈으로 버그를 찾는 일이 확 줄었다. 기계가 먼저 잡아 주니까.
그러다 자연스럽게 떠오른 질문이 있다 — 그럼 회사에서 품질을 책임지는 QA라는 역할은, 이렇게 기계가 다 먹는 것 아닌가? 요즘은 한 걸음 더 나간다. AI가 요구사항만 주면 테스트 케이스를 통째로 써 준다. 그러니 "QA는 곧 없어질 직업"이라는 말이 심심찮게 들린다. 그런데 내 관문 시스템을 직접 굴려 보면서 깨달은 건 정반대였다. 저 질문은 틀린 전제 위에 서 있다 — QA가 '버그 찾는 사람'이라는 전제다. QA는 원래 그게 아니었다.
QA는 '발견'이 아니라 '예방'에서 출발했다
먼저 세 단어를 갈라야 한다. 현장에서 자주 뭉뚱그려 쓰지만 전혀 다른 층위에 있는 말들이다. 품질 보증(QA, Quality Assurance), 품질 관리(QC, Quality Control), 그리고 테스트(testing)다. 이 셋의 관계를 그림으로 먼저 놓고 가자.

다이어그램 설명. 바깥에서 안으로 갈수록 범위가 좁아지는 포함 관계를 한 줄로 늘어놓은 것이다. 가장 넓은 품질 보증은 "어떻게 일하면 결함이 덜 나오는가"를 다루는 과정(process)의 문제다 — 코드 리뷰 규칙, 배포 절차, 요구사항을 명세로 바꾸는 방식 같은 것을 설계해 결함을 태어나기 전에 막는 쪽이다. 그 안의 품질 관리는 이미 만들어진 결과물을 기준에 비춰 보는 일이고, 가장 안쪽의 테스트는 그 점검을 실제로 수행하는 손발에 해당한다. 핵심은 방향이다 — 품질 보증은 예방이고, 테스트는 발견이다. 둘은 목적부터 다르다. 그런데 업계가 조용히 이 셋을 "테스트하는 사람" 하나로 눌러 합치면서, 가장 넓고 중요한 바깥 테두리(과정을 설계하는 일)가 보이지 않게 됐다. "QA가 곧 사라진다"는 말은 사실 가장 안쪽의 테스트 수행만 보고 바깥 테두리를 통째로 지워 버린 착시다.
품질 보증이 과정 지향이고 테스트가 산출물 지향이라는 구분은 교과서적인 정의이기도 하다. 품질 보증은 개발 전 과정에 걸쳐 꾸준히 작동하며 결함을 예방하는 쪽이고, 테스트는 거의 완성된 제품에서 결함을 찾아내는 쪽이라 보통 개발 후반부에 몰린다. 한쪽은 "왜 이런 버그가 반복해서 나는가, 과정의 어디를 고쳐야 하는가"를 묻고, 다른 쪽은 "지금 이 빌드에 버그가 있는가"를 묻는다. 둘 다 필요하지만, QA라는 직함이 진짜로 가리키는 무게 중심은 앞쪽에 있다.
AI가 오기 전에도 QA는 '끝단 관문'을 떠나고 있었다
이 오해를 풀 실마리는 사실 AI보다 먼저 와 있었다. 지난 몇 년간 품질 분야에서 가장 큰 흐름은 시프트 레프트(shift-left)였다. 개발 일정을 왼쪽(초반)과 오른쪽(후반)으로 그렸을 때, 끝에 몰려 있던 품질 활동을 앞쪽으로 당긴다는 뜻이다. 이게 왜 중요한지는 두 방식을 나란히 놓고 보면 분명해진다.

▲ 옛 방식 — 끝단의 품질 관문
다이어그램 설명. 품질을 출시 직전의 마지막 문 하나로 두는 전통적 구조다. 개발이 끝난 다음에야 QA가 결함을 처음 만나므로, 요구사항을 잘못 이해한 설계 오류 같은 큰 문제도 가장 늦게, 가장 비싼 시점에 드러난다. 되돌리는 화살표가 그 비용을 말해 준다 — 다 지어 놓은 집에서 기둥이 틀렸다는 걸 발견하는 셈이다. 이 구조에서 QA는 자연스럽게 "마지막에 버그를 걸러 내는 사람"으로 보인다. 바로 이 그림이 "QA = 테스터" 오해를 키운 토양이다.

▲ 시프트 레프트 — 앞으로 당긴 품질
다이어그램 설명. 같은 일을 시간축 앞쪽으로 흩뿌린 구조다. 품질을 결정하는 가장 중요한 순간이 맨 앞 요구사항 단계로 이동한 게 눈에 띈다 — "무엇을 만들 것이며 무엇이 '잘 만든 것'인가"를 코드 한 줄 쓰기 전에 QA가 함께 못 박는다. 개발 중에는 개발자가 직접 테스트를 쓰고, 반복적인 점검은 자동 관문이 가져간다. 그래서 QA에게 남는 일은 "무엇을 왜 테스트할지 정하는 전략", 자동화가 놓치는 틈을 사람의 직관으로 뒤지는 탐색적 테스트, 그리고 "이번 변경에서 가장 위험한 곳은 어디인가"를 가려내는 위험 판단으로 올라선다. 여기서 품질은 더 이상 QA 한 팀의 소유물이 아니다 — 개발자·기획자까지 포함한 팀 전체가 품질을 나눠 책임지고(whole-team quality), QA는 그 판을 설계하고 이끄는 안내자가 된다. 주의할 점 하나 — 시프트 레프트는 "QA를 일찍 부르자"가 아니라 "누가 테스트하느냐"에서 "누가 품질을 소유하느냐"로 질문을 바꾸는 일이다. 사람만 앞으로 당기고 책임 구조가 그대로면 아무것도 안 바뀐다.
구체적인 장면으로 그려 보면 차이가 더 분명하다. 결제 기능을 하나 붙인다고 하자. 옛 방식에서 QA는 결제 화면이 다 만들어진 뒤 "카드번호를 이렇게 넣으면 터지나"를 두드려 본다. 시프트 레프트에서는 그 전에 질문이 바뀐다 — "환불 중에 또 환불을 누르면 어떻게 되나", "결제는 됐는데 영수증 발송이 실패하면 돈과 기록이 어긋나지 않나" 같은 위험 시나리오를 요구사항 단계에서 먼저 끄집어낸다. 앞의 것은 완성된 화면에서 버그를 찾는 일이고, 뒤의 것은 애초에 그 버그가 설계에 박히지 않도록 막는 일이다. 같은 사람이 같은 기능을 보는데, 어느 시점에 개입하느냐에 따라 "발견"이 "예방"으로 바뀐다. QA의 진짜 값어치는 늘 뒤쪽에 있었다.
그러니까 AI가 등장하기 한참 전부터, QA의 무게 중심은 이미 "끝에서 버그 찾기"에서 "앞에서 품질을 설계하기"로 옮겨 가는 중이었다. AI는 이 이동을 새로 시작한 게 아니라 가속하고, 동시에 더 또렷하게 드러냈을 뿐이다.
AI가 먹는 건 '넓이', 사람이 쥐는 건 '깊이'
그럼 AI는 QA의 어느 부분을 가져갈까. 2026년 현재 생성형 AI의 가장 흔한 품질 분야 활용처는 "요구사항이나 사용자 스토리에서 테스트 케이스를 생성"하는 일이다. 예전엔 테스터가 몇 달 걸려 손으로 짜던 걸 AI가 요구사항·사용자 행동·과거 결함 이력을 훑어 한 번에 뽑아 준다. 테스트를 돌리고, 깨진 자동화 스크립트를 스스로 고치고(self-healing), 어디를 더 봐야 할지 최적화하는 일까지 AI가 주도하기 시작했다. 일을 넓이와 깊이로 갈라 보면 경계가 선명하다.

다이어그램 설명. "QA가 하던 일"을 성격이 다른 두 갈래로 가른 그림이다. 넓이에 해당하는 일 — 수많은 경우를 테스트로 펼치고, 돌리고, 환경이 바뀌어 깨진 스크립트를 다시 맞추는 반복 노동 — 은 AI가 놀랄 만큼 잘한다. 반면 깊이에 해당하는 일은 성격이 다르다. "이 제품에서 품질이란 대체 무엇을 뜻하는가", "한정된 시간에 어디부터 집중해 테스트할 것인가", 그리고 가장 중요하게 "AI가 뽑아낸 이 결과가 진짜로 맞는가"를 가리는 판단이다. 업계가 몸으로 배운 교훈이 바로 이 분리였다 — 생성형 AI는 넓이에서 탁월하지만 깊이에서는 사람의 판단을 요구한다. 그래서 지금 가장 잘 먹히는 방식은 "AI가 초안을 쏟아내고, 경험 있는 사람이 그걸 검증하고 추려 내는" 조합이다. 함정은 여기 있다 — AI가 테스트를 1000개 만들어 줬다는 사실은 품질을 보장하지 않는다. 그 1000개가 정작 중요한 위험을 겨냥하고 있는가, 그리고 통과했다는 그 결과를 믿어도 되는가는 여전히 사람이 답해야 하는 질문이다.
이 "깊이"의 정체를 한 가지 더 뾰족하게 짚고 싶다. AI가 못 하는 판단의 핵심은 명세 자체를 의심하는 일이다. AI는 주어진 요구사항에 충실한 테스트를 뽑는다 — 문제는 그 요구사항이 틀렸을 때다. "회원 탈퇴 시 데이터를 삭제한다"는 명세를 주면 AI는 삭제가 잘 되는지 꼼꼼히 검사하는 테스트를 만든다. 전부 통과한다. 그런데 정작 중요한 질문 — "법적으로 결제 기록은 5년간 보관해야 하는데, 이 삭제가 그걸 같이 지워 버리지 않나" — 는 명세에 없으니 테스트에도 없다. AI가 만든 1000개의 초록불은 명세가 옳다는 전제 위에서만 초록불이다. 그 전제를 흔들어 보는 것, "우리가 지금 맞는 것을 만들고 있는가"를 되묻는 것이 QA가 쥔 깊이의 본체다. AI는 "이걸 제대로 만들었나"에는 답하지만 "이게 만들 가치가 있는 옳은 것인가"에는 답하지 못한다.
그래서 QA 리더의 역할은 "모든 테스트를 직접 돌리는 사람"에서 "품질 목표를 정의하고 AI가 만들어 낸 결과를 지휘·검수하는 오케스트레이터"로 바뀌고 있다. 실제로 기업의 58%가 QA 인력을 AI 도구 쪽으로 재교육하고 있고, 빠르게 크는 역량은 테스트 생성을 위한 프롬프트 설계, AI 출력 검증, 위험 기반 테스트 설계 같은 것들이다. 반대로 손으로 스크립트를 짜던 전통 기술의 상대적 비중은 줄고 있다. 사라지는 건 QA가 아니라, QA의 일 중에서 원래부터 가장 기계적이었던 층이다.
병목은 '테스트를 쓰는 일'에서 '맞는지 판단하는 일'로 옮겨 간다
이걸 내 작은 관문 시스템으로 되돌아와 보면 더 잘 보인다. 앞서 말한 커밋 직전 자동 점검 — 테스트·타입 검사·커버리지·보안 스캔 — 이 사실상 1인짜리 품질 보증 체계다. 그런데 이 체계를 굴리면서 깨달은 건, 기계가 가져간 것과 끝내 내가 쥐고 있는 것이 명확히 갈린다는 점이다.

다이어그램 설명. 관문의 동작 자체는 단순하다 — 커밋이 들어오면 여러 검사를 돌리고, 하나라도 실패하면 고칠 때까지 막는다. 여기서 "검사를 돌리고 실패를 막는" 실행은 전부 기계가 한다. 하지만 이 그림에 안 보이는 결정들이 진짜 QA의 일이다. 커버리지의 "정해 둔 선"을 몇 퍼센트로 잡을지, 어떤 프로젝트에 타입 검사를 강제하고 어떤 프로젝트는 유예할지, 보안 스캔에서 이미 알고 있는 이슈는 어디까지 눈감아 줄지 — 이 "무엇을 어디까지 품질로 볼 것인가"는 기계가 정해 주지 않는다. 내가 정한다. 기계는 내가 그어 둔 선을 집행할 뿐이고, 그 선을 어디에 긋느냐가 품질 보증의 전부에 가깝다. AI에게 "테스트 더 써 줘"라고 시키는 건 쉬워졌지만, "이 정도면 출시해도 되는가"라는 질문의 답은 여전히 내 몫으로 남는다.
이 지점에서 품질 작업의 병목이 이동한다. 예전엔 "테스트를 충분히 많이 쓰는 것"이 느리고 비싼 일이라 거기가 병목이었다. AI가 그걸 싸게 만들어 버리자, 병목은 그 다음 칸 — "쏟아진 결과물이 정말 맞는지 판단하는 일"로 넘어간다. 코드와 테스트를 만드는 속도가 빨라질수록, 그것을 믿어도 되는지 검증하는 쪽이 상대적으로 더 좁은 목이 된다. 그리고 이 검증과 판단이야말로, 세 단어를 갈랐을 때 가장 바깥 테두리에 있던 품질 보증의 본래 자리다.
정리 — QA는 쪼그라드는 게 아니라, 원래 QA가 아니던 부분을 벗는다
그러니 "AI가 테스트를 써 주니 QA는 끝"이라는 말은, QA를 테스트 수행과 동일시한 오해에서만 성립한다. QA의 본래 일은 버그를 찾는 게 아니라 '무엇이 충분히 좋은가'를 정의하고 그 선을 지키는 것이었다. AI는 그 정의를 대신 내려 주지 못한다 — 다만 발견과 실행이라는, 원래부터 가장 기계적이던 층을 아주 싸게 만들어 줄 뿐이다.
결국 AI 시대의 QA는 작아지는 게 아니라, 자기가 아니던 부분을 벗고 자기 핵심으로 돌아온다. 반복 실행은 기계에 넘기고, 사람은 "무엇을 왜 품질로 볼 것인가"와 "이 결과를 믿어도 되는가"라는 판단에 집중한다. 개인 작업에 적용해도 똑같다 — 나는 AI에게 테스트를 더 뽑게 하되, 커버리지의 선을 어디에 긋고 어떤 결과를 신뢰할지는 계속 내 손으로 정한다. 도구가 발견을 아무리 싸게 만들어도, 무엇이 좋은 것인지 정하는 일만큼은 끝까지 사람의 몫이라는 걸, 작은 관문 하나를 굴려 보며 매일 확인하는 중이다.
참고한 공개 자료:
- Software Quality Assurance vs. Quality Control vs. Testing — TestFort
- What is quality assurance (QA) in software development? — LogRocket Blog
- Adopting Shift-Left Testing — PractiTest
- How Whole-Team Quality Improves Software Development — DEV Community
- QA trends for 2026: AI, agents, and the future of testing — Tricentis
- AI in Quality Engineering: How AI Is Reshaping Software Testing and QE in 2026 — Testrig Technologies
- World Quality Report 2026: AI QA Trends Every Team Needs — QA Skills
이 글은 생성형 AI의 도움을 받아 작성되었습니다. 원본 자료를 기반으로 AI가 초안을 생성하고, 작성자가 검토·편집하였습니다.
'IT' 카테고리의 다른 글
AWS 인터넷 게이트웨이(IGW) — 서버는 자기 공인 IP를 모른다, 문지기가 1:1로 붙여줄 뿐이다 (0) 2026.10.20 AWS VPC — 격리된 빈 땅을 받고, 그 안을 어떻게 나눌 것인가 (0) 2026.10.19 AWS 보안그룹 — IP가 아니라 '소속'으로 짜는 방화벽, 그리고 포기한 것 (0) 2026.10.18 AWS bastion host — 프라이빗 서버로 가는 단 하나의 문, 그리고 그 문을 지키는 값 (0) 2026.10.17 Leiden 알고리즘 — Louvain이 남긴 '끊어진 모듈'을 정제 한 칸으로 막는 법 (0) 2026.10.16 AI와 짝코딩하며 '검증했다'고 할 때, 그 검증은 무엇인가 — verification·validation·테스트, 그리고 누가 확인하는가 (0) 2026.10.14 Louvain 클러스터링 — 함수 수천 개를 사람 손 없이 모듈로 묶는 2008년생 알고리즘 (0) 2026.10.13 BM25는 왜 아직도 AI 에이전트의 RAG에 박혀 있나 — 1994년 검색 공식과 임베딩의 상반된 맹점 (0) 2026.10.12 graphify가 LLM에게 건네는 단어 12개 — 코드 덩어리에 이름을 붙이는 '증거 풀'의 정체 (0) 2026.10.11 graphify엔 한국어 불용어가 없다 — 그런데 왜 한국 사용자는 큰 불편 없이 쓰고 있을까 (0) 2026.10.10