-
카나리 릴리스 — 새 버전을 사용자 1%에게만 먼저 흘려보내고 지표로 판정한다IT 2026. 9. 22. 22:00
▶ 동영상 개요 — 카나리 릴리스 — 새 버전을 사용자 1%에게만 먼저 흘려보내고 지표로 판정한다
5분 31초 — 카나리 릴리스는 위험을 작게 잘라 먼저 맞는다 — 새 버전을 사용자 1~5%에게만 흘려보내고, 같은 시각 옆에서 도는 안정 버전과 지표를 통계로 비교(Kayen… — NotebookLM 동영상 개요로 생성 🎧 오디오 개요 — 카나리 릴리스 — 새 버전을 사용자 1%에게만 먼저 흘려보내고 지표로 판정한다
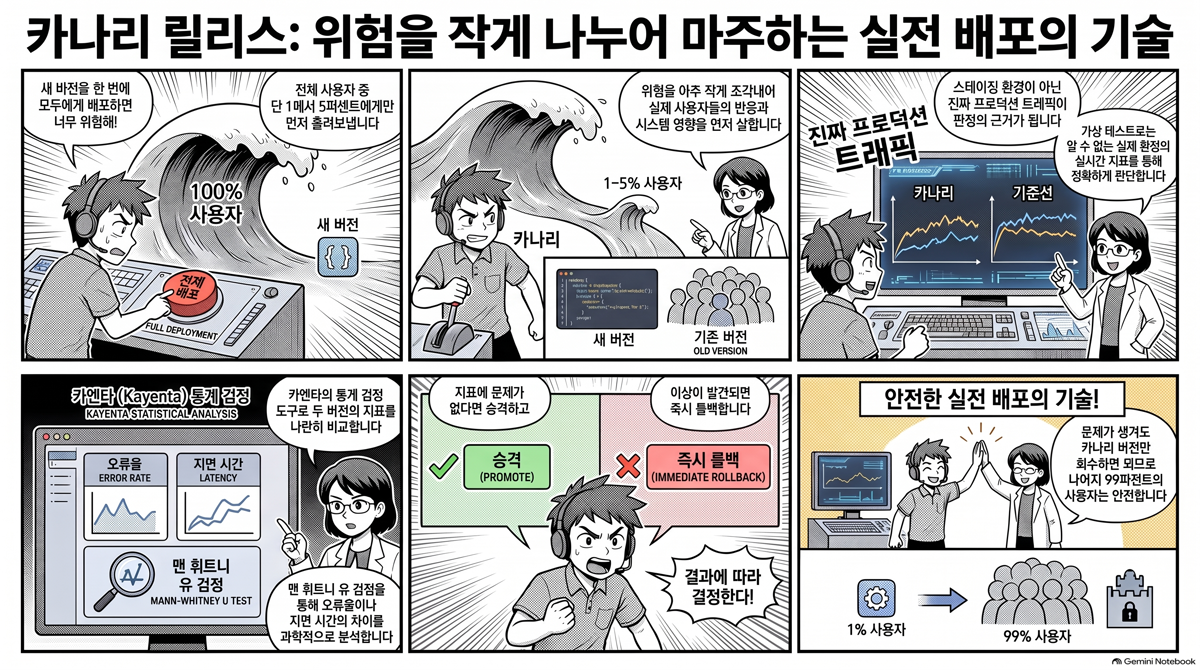
20분 29초 — 카나리 릴리스는 위험을 작게 잘라 먼저 맞는다 — 새 버전을 사용자 1~5%에게만 흘려보내고, 같은 시각 옆에서 도는 안정 버전과 지표를 통계로 비교(Kayen…. 화면은 이 글의 인포그래픽 한 장 고정 — NotebookLM 오디오 개요로 생성 새 버전을 프로덕션에 올리는 순간은 늘 조마조마하다. 스테이징(staging — 프로덕션과 똑같이 꾸민 시험 환경)에서 아무리 돌려 봐도, 진짜 사용자가 진짜 데이터로 진짜 부하를 걸었을 때 무슨 일이 벌어질지는 끝내 알 수 없다. 그래서 "일단 전부 바꾸고 문제가 생기면 되돌린다"는 방식은, 문제가 생기는 순간 이미 모든 사용자가 그 문제를 맞은 뒤다.
카나리 릴리스(canary release)는 이 순서를 뒤집는다. 이름은 탄광의 카나리에서 왔다 — 광부들이 유독가스에 민감한 카나리를 데리고 들어가, 새가 먼저 쓰러지면 자기들이 위험을 알아챘다. 소프트웨어에서 카나리는 새 버전을 받은 소수의 사용자다. 새 버전을 기존 버전 옆에 나란히 띄우고, 전체 트래픽 중 아주 일부(흔히 1~5%)만 새 버전으로 흘려보낸다. 그 소수에게서 지표가 멀쩡하면 조금씩 비율을 늘리고, 나빠지면 그 소수만 되돌린다. 나머지 대다수는 처음부터 끝까지 안전한 옛 버전을 쓴다.
카나리 릴리스의 목적 — 진짜 트래픽을 소량으로 먼저 쬔다
카나리의 핵심 가치는 "위험을 줄인다"가 아니라 "위험을 작게 잘라 먼저 맞는다"는 데 있다. 새 버전에 치명적 결함이 있어도, 그 결함을 맞는 사람이 전체의 1%면 피해도 1%다. 그동안 지표가 그 결함을 드러내 주면, 나머지 99%로 번지기 전에 멈춘다.

다이어그램 설명. 이 그림이 보여주는 건 카나리 릴리스가 트래픽을 쪼개 두 버전에 동시에 흘린다는 점이다. "들어오는 사용자 트래픽"이 안정 버전과 카나리 버전으로 갈라져 각각 95%와 5%를 받고, 두 갈래 모두 "두 버전의 지표를 나란히 비교"하는 단계로 모인다. 여기서 차이가 없으면 카나리 비율을 확대하고, 나빠지면 카나리만 회수한다. 이 구조가 중요한 이유는 비교 대상이 과거가 아니라 지금 옆에서 도는 안정 버전이기 때문이다. "어제보다 느려졌나"가 아니라 "같은 시각, 같은 부하에서 옛 버전보다 나쁜가"를 묻는다. 놓치기 쉬운 함정은 카나리에 트래픽을 너무 조금 주는 것이다 — 1%가 하루에 요청 열 건이면 통계적으로 아무것도 판정할 수 없다. 지표가 의미를 가지려면 그 소수에게도 충분한 표본이 쌓여야 한다.
사람이 눈으로 보던 판정을 통계로 — Netflix의 Kayenta
카나리의 어려운 부분은 배포가 아니라 판정이다. "카나리가 나빠졌다"를 사람이 대시보드를 보며 눈으로 정하면, 느리고 주관적이고 놓친다. Netflix와 Google이 공동으로 만들어 공개한 Kayenta는 이 판정을 통계로 자동화했다.
Kayenta의 발상은 정직하다. 카나리 지표와 기준(baseline) 지표를 모아 Mann-Whitney U 검정(두 표본의 분포가 유의미하게 다른지 보는 비모수 통계 검정)으로 각 지표를 판정한다. 지표마다 "통과(Pass)", "높음(High)", "낮음(Low)"으로 분류하고, 전체 지표 중 "통과"의 비율로 점수를 낸다. 이 점수가 미리 정한 기준을 넘으면 자동 승격, 못 넘으면 자동 롤백, 애매하면 사람에게 넘긴다. 규모도 인상적이다 — Kayenta는 한때 Netflix 카나리 판정의 약 30%를 처리하며 하루 평균 200건을 판정했다.
여기서 Kayenta가 짚은 미묘한 함정이 하나 있다. 카나리를 오래 돌아 데워진 옛 인스턴스와 비교하면 안 된다는 것이다. 갓 뜬 새 인스턴스는 캐시가 비어 있고 JIT 최적화가 덜 됐고 커넥션 풀도 차오르는 중이라, 그것만으로 잠깐 느리다. 그래서 Kayenta는 카나리와 같은 시점에 새로 띄운 작은 기준 인스턴스를 붙여, 둘 다 "갓 태어난" 상태로 맞춰 비교한다. 코드 차이만 남기고 나머지 조건을 같게 만드는 것 — 이게 통계 비교의 공정함을 지킨다.
비율을 넓히는 사다리와, 무엇을 지켜볼 것인가
카나리는 한 번에 100%로 가지 않는다. Netflix가 쓰는 사다리는 1% → 5% → 25% → 100%처럼 단을 밟아 오른다. 각 단마다 지표를 지켜보는 창을 두고, 통과해야 다음 단으로 올라간다. 이렇게 하는 이유는 결함이 부하가 커져야 드러나는 경우가 있기 때문이다. 1%에서는 멀쩡하던 메모리 누수가 25%의 부하에서 터지기도 한다. 사다리는 그 임계점을 낮은 비율에서 미리 만나게 해 준다.
그렇다면 어느 지표를 봐야 하나? 실무에서 카나리 판정의 무게는 세 갈래에 실린다. 첫째는 오류율(HTTP 500 같은 실패 응답의 비율)이다 — 가장 직접적이고 빠르게 나빠지는 신호다. 둘째는 지연 시간, 특히 p99(가장 느린 1%의 응답 시간 — 평균은 멀쩡해 보여도 꼬리가 길어지면 일부 사용자가 크게 느려진다)다. 셋째는 비즈니스 지표(결제 성공률, 로그인 성공률처럼 돈과 직결된 값)다. 앞의 둘이 초록불이어도 결제 성공률이 떨어지면 카나리는 실패다 — 기술적으로는 멀쩡한데 사용자가 돈을 못 내는 상태가 가장 위험하기 때문이다. 그래서 자동 판정은 이 여러 지표를 묶어 하나의 점수로 낸 뒤, 그 점수가 기준을 넘으면 다음 단으로 올리고 못 넘으면 되돌린다.
블루-그린과 어디서 갈라지나
배포 전략을 얘기하면 블루-그린(blue-green — 똑같은 환경 두 벌을 두고 한 번에 통째로 전환하는 방식)과 자주 헷갈린다. 나란히 놓으면 성격이 분명해진다.
축 카나리 릴리스 블루-그린 배포 전환 방식 1→5→25→100 점진적 0→100 한 번에 새 버전을 맞는 사람 처음엔 소수만 전환 순간 전부 결함이 있을 때 피해 카나리 비율만큼 전환 뒤 전원 판정 근거 진짜 트래픽에서의 지표 전환 전 검증에 의존 되돌리기 비율을 0으로 트래픽을 옛 환경으로 되돌림 블루-그린의 장점은 되돌리기가 즉각적이라는 것이고, 약점은 전환 순간 전원이 새 버전을 맞는다는 것이다. 카나리는 그 순간을 잘게 쪼개 "새 버전을 진짜 트래픽으로 검증하는 창"을 만든다. 스테이징 검증에만 의존하는 블루-그린과 달리, 카나리는 판정 근거를 프로덕션 실측에서 얻는다.
사용자가 나 혼자인 서버에서도 쓸 수 있나
솔직히 짚자면, 카나리는 사용자가 많을수록 빛난다. 트래픽을 1%로 쪼개도 표본이 쌓이려면 애초에 전체 트래픽이 커야 한다. 사용자가 나 혼자인 개인 서버에서는 "1%"라는 개념 자체가 성립하지 않는다.
그래도 발상은 옮겨 온다. 새 모델이나 새 버전을 올릴 때, 나는 옛 버전을 곧바로 내리지 않고 둘을 잠깐 나란히 띄운다. 그리고 내가 직접 던지는 몇 건의 요청을 새 버전으로 먼저 보내, 지연 시간과 오류 로그를 옛 버전과 비교한다. 새것이 느려지거나 이상한 응답을 내면 트래픽을 옛 버전으로 되돌리고, 멀쩡하면 옛것을 내린다. 자동 통계 판정은 없지만, "전부 바꾸고 기도하기" 대신 "작게 먼저 쬐고 비교하기"라는 카나리의 뼈대는 그대로다.
정리 — 카나리는 미리 짠 시험이 아니라 진짜 트래픽에 묻는다
카나리 릴리스가 답하는 질문은 "이 코드가 테스트를 통과하나"가 아니라 "이 코드가 진짜 사용자·진짜 부하에서 옛 버전보다 나쁘지 않나"다. 그 답은 스테이징에서 나오지 않는다 — 진짜 트래픽을 소량으로 쬐어 봐야만 나온다. 그래서 카나리는 위험을 없애는 도구가 아니라 위험을 작게 잘라 먼저 맞아 보는 도구다. 큰 사고를 1%짜리 작은 사고로 바꾸는 것, 그것이 전부다.
개인 작업이라면 자동 통계 판정까지 갖출 필요는 없다. 새 버전을 옛 버전과 잠깐 나란히 두고, 내 요청 몇 건을 먼저 새것에 보내 비교하는 습관 — 그 작은 겹침의 창이 카나리의 본질이다.
참고한 공개 자료:
- Automated Canary Analysis at Netflix with Kayenta — Netflix TechBlog
- Introducing Kayenta — Google Cloud Blog
- What Is Canary Deployment in DevOps? — TMS Outsource
이 글은 생성형 AI의 도움을 받아 작성되었습니다. 원본 자료를 기반으로 AI가 초안을 생성하고, 작성자가 검토·편집하였습니다.
'IT' 카테고리의 다른 글
DeepWiki는 이제 필요 없을까 — 모델이 코드를 읽는 시대의 문서화 (0) 2026.09.26 Kimi K2는 정말 오푸스·소네트와 붙나 — 1조 개 중 320억만 켜는 오픈 웨이트 모델의 정체 (0) 2026.09.25 GLM-5.3은 왜 갑자기 오푸스와 붙나 — 뼈대는 그대로 두고 후처리만 갈아 끼운 오픈 웨이트 모델 (0) 2026.09.24 나머지를 다 고정하고 내 것만 빠르게 — 그게 fixture인가, 최선인가 (0) 2026.09.23 합성 모니터링 — 아무도 안 쓰는 새벽 3시에 로그인·결제를 대신 밟아 주는 로봇 (0) 2026.09.22 스모크 테스트 — 배포 직후 '불이 켜지긴 하나'만 60초에 확인하는 얕고 빠른 그물 (0) 2026.09.22 테스트는 레벨마다 다른 질문에 답한다 — 로컬·통합·프로덕션에서 공통 테스트를 반복해야 할까 (0) 2026.09.22 Acorn은 플러그인도 테마도 아니다 — 워드프레스 안에 라라벨을 심는 물건의 정체와 2026년 현황 (0) 2026.09.21 라라벨은 워드프레스에 필수가 아니다 — 그런데도 '많이 쓴다'고 들리는 이유 (0) 2026.09.21 오픈클로에 Claude·Codex·Gemini 붙이기 — OAuth는 막히고 AgentRuntime은 되는 이유 (0) 2026.09.20