-
Kimi K2는 정말 오푸스·소네트와 붙나 — 1조 개 중 320억만 켜는 오픈 웨이트 모델의 정체IT 2026. 9. 25. 21:00
▶ 동영상 개요 — Kimi K2는 정말 오푸스·소네트와 붙나 — 1조 개 중 320억만 켜는 오픈 웨이트 모델의 정체
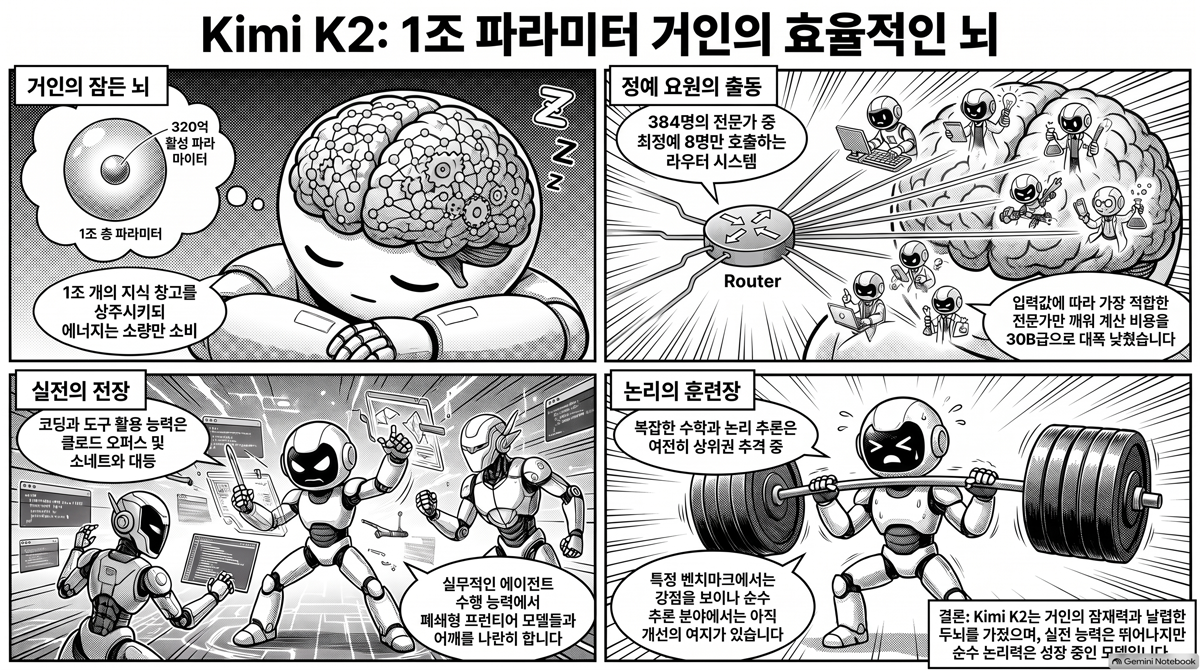
7분 46초 — Kimi K2가 총 1조 파라미터 중 한 토큰당 320억 개(전문가 384개 중 8개)만 켜는 MoE 희소 구조 덕에, 코딩·에이전트 벤치마크에서 Claude… — NotebookLM 동영상 개요로 생성 🎧 오디오 개요 — Kimi K2는 정말 오푸스·소네트와 붙나 — 1조 개 중 320억만 켜는 오픈 웨이트 모델의 정체
13분 27초 — Kimi K2가 총 1조 파라미터 중 한 토큰당 320억 개(전문가 384개 중 8개)만 켜는 MoE 희소 구조 덕에, 코딩·에이전트 벤치마크에서 Claude…. 화면은 이 글의 인포그래픽 한 장 고정 — NotebookLM 오디오 개요로 생성 나는 집에 둔 로컬 AI 서버에서 오픈 웨이트 모델을 여러 개 굴려 왔다. 양자화 설정을 바꿔 가며 같은 모델을 비교해 보는 게 취미에 가깝다. 그래서 "중국산 오픈 웨이트 모델이 코딩 벤치마크에서 Claude Opus를 넘겼다"는 헤드라인은 이제 반사적으로 걸러 듣는다. 벤치마크 한 줄로 프런티어 폐쇄형 모델과 붙었다는 주장은 흔하고, 대개 유리한 항목 하나만 크게 부풀린 것이니까.
그런데 Kimi K2를 들여다보다 숫자 하나에서 멈칫했다. 이 모델은 파라미터가 총 1조 개다. 그런데 실제로 답 하나를 만들 때 켜지는 건 그중 320억 개뿐이다. 덩치는 초대형인데 계산 비용은 30B급 소형 모델에 가깝다는 뜻이다. 그러면서 소프트웨어 작업 벤치마크에서는 Claude Opus·Sonnet과 같은 표에 이름을 올린다. 이게 사실이라면 "성능을 내려면 큰 모델을 비싸게 굴려야 한다"는 통념 하나가 흔들린다. 이 글은 Kimi K2를 만든 곳이 누구고, 어떻게 1조짜리 모델이 30B 비용으로 프런티어와 붙는지, 그리고 그 경쟁력이 어디까지가 진짜인지를 하나씩 풀어 본다.
누가 만들었나 — Moonshot AI
Kimi를 만든 곳은 Moonshot AI(月之暗面, 월지암면)다. 2023년 양지린(Yang Zhilin)이 세운 중국 AI 기업이다. 창업자는 카네기멜런대에서 박사 과정을 밟았고 구글과 메타의 AI 연구 조직을 거친 인물이다. Kimi는 이 회사가 내놓는 제품·모델 계열의 이름이고, K2는 그중 두 번째 세대 기반 모델을 가리킨다.
이 회사가 짧은 시간에 얼마나 빠르게 컸는지는 투자 궤적에 그대로 찍혀 있다. 2025년 말 43억 달러로 평가받던 기업 가치가 2026년 들어 두 배가 넘게 뛰었고, 그해 중반 20억 달러를 조달하며 200억 달러대 평가를 받았다. 늦여름에는 약 35억 달러를 더 유치하며 350억 달러 평가에 이르렀다는 보도가 나왔다. Kimi의 연환산 반복 매출(ARR, 한 해로 환산한 반복 수익)은 2026년 3월 초 1억 달러에서 두 달 만에 2억 달러를 넘겼다. 중국 AI 기업 중에서도 손꼽히게 빠른 상승 곡선이다.
여기서 오픈 웨이트(open weight)라는 말을 짚고 가야 한다. 모델의 가중치 파일을 내려받아 자기 서버에서 그대로 돌릴 수 있게 공개한 모델을 말한다. Claude·GPT 같은 폐쇄형 모델은 API를 통해서만 쓸 수 있고 내부 가중치는 공개되지 않는다. 반대로 오픈 웨이트는 인터넷 없이 로컬에서 실행하고, 뜯어보고, 미세조정까지 할 수 있다. K2는 2025년 7월 수정 MIT 라이선스(Modified MIT License, 상업적 사용까지 폭넓게 허용하는 개방형 라이선스)로 가중치를 공개했다. 프런티어 성능을 좇으면서도 가중치를 연다는 것 — 그게 이 회사가 택한 차별화의 축이다.
1조 개인데 320억만 켠다 — 희소 전문가 구조
Kimi K2의 경쟁력을 이해하려면 MoE(Mixture of Experts, 전문가 혼합)라는 구조부터 봐야 한다. 전통적인 모델은 입력이 들어오면 모든 파라미터가 다 계산에 참여한다. 파라미터가 1조 개면 1조 개가 전부 돌아가니 비용이 폭발한다. MoE는 이 방식을 뒤집는다. 모델 안에 작은 전문가 신경망 여러 개를 두고, 입력 토큰마다 그중 몇 개만 골라 켠다. 나머지는 잠들어 있다.

다이어그램 설명. 이 그림이 보여주는 건 하나다 — 1조 개 전부가 아니라 극히 일부만 켜서 답을 만든다는 것이다. "입력 토큰 하나"가 들어오면 "라우터"가 384개의 전문가 중 이 토큰에 가장 알맞은 8개만 고른다. 그렇게 켜진 전문가 8개를 합쳐도 계산에 참여하는 건 약 320억 파라미터뿐이고, "전문가 전체 풀"에 담긴 1조 개 중 나머지는 잠든 채 이번 계산에 끼지 않는다. 왜 이 구조가 중요한가 하면, 지식의 총량은 1조 개만큼 넓게 담아 두면서 한 번의 계산 비용은 320억 개짜리 소형 모델 수준으로 낮추기 때문이다. 큰 도서관을 지어 두되 질문 하나에 필요한 책 몇 권만 꺼내 읽는 셈이다. 놓치기 쉬운 함정은 "그럼 나머지 잠든 파라미터는 안 써도 되니 메모리에서 빼도 되지 않나"라는 오해인데, 다음 토큰에서는 다른 전문가가 켜질 수 있으므로 1조 개 전부를 메모리에 올려 둬야 한다. 계산은 가볍지만 저장 공간은 여전히 1조 개짜리라는 점이 뒤에서 다룰 로컬 실행의 벽이 된다.
그런데 파라미터를 1조 개까지 키우면서 학습을 안정적으로 끝내는 것 자체가 난제다. 모델이 커질수록 학습 도중 손실값이 갑자기 튀어 오르는 손실 스파이크(loss spike, 학습이 발산해 성능이 무너지는 현상)가 잦아지기 때문이다. Moonshot은 이를 MuonClip이라는 자체 최적화 기법으로 넘었다. Muon이라는 최신 최적화 알고리즘에, 특정 값이 과도하게 커지지 못하게 잘라내는(QK-clip) 안정화 장치를 붙인 것이다. 이 조합으로 K2는 15조 5천억 개의 토큰을 학습하는 동안 손실 스파이크를 한 번도 겪지 않았다고 보고됐다. 최적화 기법 하나가 초대형 모델을 "학습이 가능한 물건"으로 만든 사례다. 이게 사람에게 주는 값은 명확하다 — 1조짜리 오픈 웨이트 모델이 실제로 세상에 나올 수 있었던 기술적 토대가 여기에 있다.
여기에 더해 K2는 후처리 단계에서 에이전트 작업에 집중했다. 에이전트 작업이란 모델이 한 번 답하고 끝나는 게 아니라, 도구를 부르고 파일을 뒤지고 명령을 내리고 실패하면 다시 시도하는 긴 호흡의 과업을 말한다. Moonshot은 이런 과업을 대량으로 합성해 훈련 데이터로 만들고, 실제·가상 환경과 모델이 주고받는 강화학습(좋은 결과에 보상을, 나쁜 결과에 벌점을 줘 행동을 교정하는 학습) 단계를 거쳤다. 코딩과 도구 사용이 K2의 특기가 된 건 우연이 아니라 이 훈련 설계의 결과다.
그래서 Opus·Sonnet과 붙나 — 코딩은 최상위권, 추론은 추격 중
이제 본론이다. 부풀린 헤드라인을 걷어내고 숫자를 있는 그대로 본다. 가장 눈에 띄는 건 K2 계열의 최신판(K2.6)이 제3자 평가에서 오픈 웨이트 모델 1위, 전체 모델 중에서는 4위에 올랐다는 점이다. 독립 평가 기관 Artificial Analysis의 종합 순위 기준이다. 만든 쪽이 낸 성적표가 아니라 제3자 측정이라는 점에서 무게가 다르다.
세부 항목으로 들어가면 코딩·에이전트 쪽 강세가 뚜렷하다. 현재 가장 어려운 코딩 벤치마크로 꼽히는 SWE-Bench Pro(실제 소프트웨어 저장소의 이슈를 코드 수정으로 해결하는 과제)에서 K2.6은 58.6점을 냈다. 같은 기준에서 GPT 계열 최신판이 57.7, Claude Opus 4.6이 53.4, Gemini 계열이 54.2였다. 한 번의 시도로 실제 이슈를 해결하는 SWE-bench Verified에서는 65.8%를 기록했다.
SWE-Bench Pro (높을수록 좋음) 점수 형태 Kimi K2.6 58.6 오픈 웨이트 GPT 계열 최신판 57.7 폐쇄형 API Gemini 계열 최신판 54.2 폐쇄형 API Claude Opus 4.6 53.4 폐쇄형 API 표 설명. 이 표에서 읽어야 할 건 등수 자체가 아니라 어떤 진영이 어디에 있는가다. 오픈 웨이트인 Kimi K2.6이 폐쇄형 프런티어 모델 세 개를 이 한 항목에서 앞섰다. 다만 두 가지 단서를 달아야 한다. 첫째, 점수 차이가 58.6 대 53.4 정도로 크지 않다 — 벤치마크 버전이나 측정 조건이 조금만 바뀌어도 순위가 뒤집힐 수 있는 간격이다. 둘째, 여기 적힌 Opus·GPT의 버전은 이 측정 시점의 것이고, 폐쇄형 모델은 조용히 갱신되므로 지금 이 순간의 최신판과는 다를 수 있다. "한 벤치마크에서 앞섰다"를 "전반적으로 더 낫다"로 확대 해석하면 안 된다는 뜻이다. 확실한 결론은 하나다 — 코딩이라는 특정 영역에서 오픈 웨이트가 폐쇄형 프런티어와 같은 표에 오를 만큼 좁혀졌다.
하지만 여기서 정직해야 한다. K2의 강세는 영역을 심하게 탄다. 에이전트 도구 사용, 코딩, 긴 호흡의 작업에서는 최상위권이지만, 복잡한 수학·논리 같은 순수 추론으로 넘어가면 프런티어 폐쇄형 모델을 아직 앞서지 못하고 추격하는 위치다. 앞서 본 훈련 설계가 에이전트·코딩에 집중했으니 자연스러운 결과이기도 하다.

다이어그램 설명. 이 그림은 "K2가 좋냐 나쁘냐"라는 이분법이 왜 틀린 질문인지 보여준다. "Kimi K2.6의 실력 지형"이 두 갈래로 갈라지는데, 한쪽인 에이전트·코딩·도구 사용에서는 폐쇄형 프런티어와 대등하거나 앞서고, 다른 쪽인 순수 추론에서는 여전히 추격하는 위치다. 이 비대칭이 실전 선택의 기준이 된다 — 코드를 짜고 도구를 부리는 에이전트 용도라면 K2는 진지한 후보지만, 어려운 수학 증명이나 다단계 논리 퍼즐이 핵심인 작업이라면 아직 프런티어 폐쇄형이 안전하다. 놓치기 쉬운 함정은 종합 순위 4위라는 숫자만 보고 "모든 작업에서 4위"로 읽는 것이다. 그 순위는 여러 영역의 평균이고, 실제로는 잘하는 영역과 못하는 영역의 편차가 크다.
같은 중국 오픈 웨이트 진영의 GLM 계열과 비교하면 성격이 더 또렷해진다. 둘 다 MoE 구조에 코딩·에이전트를 겨냥한 오픈 웨이트라는 점은 같지만, K2는 총 1조 파라미터로 덩치가 더 크고, 오픈 웨이트 모델을 API로 골라 쓰는 중개 플랫폼(OpenRouter)에서 2026년 중반 기준 두 번째로 많이 쓰인 모델에 오를 만큼 실사용 채택이 넓다. 벤치마크 배지보다 이 "실제로 많이 쓴다"는 지표가 더 정직한 경쟁력 신호에 가깝다.
가격과 로컬 — 무기이자 벽
K2의 또 다른 무기는 가격이다. 중개 플랫폼 기준 K2.6은 입력 100만 토큰당 0.74달러, 출력 100만 토큰당 3.50달러다. 같은 작업을 Claude Sonnet(입력 3달러·출력 15달러)으로 돌릴 때와 비교하면 출력 기준 네 배 넘게 싸고, 더 비싼 Opus와 비교하면 격차는 스무 배 안팎까지 벌어진다. 성능이 코딩 영역에서 프런티어에 근접하면서 비용 구조가 이렇게 다르면, "코딩 에이전트에 굳이 폐쇄형을 써야 하나"라는 질문이 진지해진다.
여기에 가중치까지 공개돼 있으니, API 비용조차 들이지 않고 자기 하드웨어에서 돌리는 선택지도 이론상 생긴다. 그런데 이 대목에서 현실적인 벽을 정직하게 짚어야 한다. 앞서 본 MoE 구조 때문에 계산은 320억짜리처럼 가벼워도, 저장은 1조 개 전부를 메모리에 올려야 추론이 된다. 1조 개 파라미터는 압축(양자화)을 세게 걸어도 수백 기가바이트급 메모리를 요구한다. 내가 로컬 서버에서 양자화 설정을 바꿔 가며 모델을 굴려 본 경험으로 보면, 이 정도 규모는 개인 PC 한 대로 감당할 물건이 아니다.
그래서 K2 같은 초대형 오픈 웨이트의 실익은 "누구나 노트북에서 돌린다"가 아니다. 조직이나 추론 서비스가 자기 인프라에서 독립적으로 운용하고, 데이터를 밖으로 내보내지 않고, 필요하면 미세조정까지 한다는 쪽에 있다. 개인 사용자에게 열린 문은 오히려 앞서 본 저렴한 API 쪽이다. 오픈 웨이트라는 단어를 "내 노트북에서 공짜로"로 번역하면 실망하기 쉽다 — 진짜 값은 통제권과 비용 구조에 있다.
정리 — 덩치가 아니라 희소성이 만든 경쟁력
Kimi K2를 한 줄로 요약하면 이렇다. 1조 개 중 320억 개만 켜는 희소 구조로, 초대형 모델의 지식 폭과 소형 모델의 계산 비용을 동시에 쥔 오픈 웨이트 모델이다. 그 덕에 코딩·에이전트라는 특정 영역에서는 Claude Opus·Sonnet과 같은 표에 이름을 올렸고, 값은 폐쇄형의 몇 분의 일에서 스무 분의 일까지 싸다. 다만 순수 추론에서는 아직 추격 중이고, 1조 개 가중치를 올릴 메모리는 개인용이 아니다.
로컬에서 모델을 굴리는 입장에서 이 소식의 무게는 실용적이다. "코딩 에이전트에 쓸 만한 오픈 웨이트"의 기준선이 조용히, 그러나 빠르게 올라가고 있다. 다음에 모델을 고를 때 나는 벤치마크 종합 순위 배지보다 세 가지를 먼저 볼 생각이다 — 그 점수가 내가 실제로 시킬 작업(코딩인가 추론인가)과 같은 영역에서 난 것인지, 자체 측정인지 제3자 측정인지, 그리고 그 가중치를 내 하드웨어가 실제로 올릴 수 있는 규모인지. 덩치 큰 모델이 이겼다는 헤드라인보다, 무엇을 어떻게 켜서 그 성능을 냈는지가 더 많은 걸 말해 준다.
참고한 공개 자료:
- Kimi K2: Open Agentic Intelligence (기술 보고서) — arxiv.org
- Analysis of the Kimi K2 Open-Weight Language Model — intuitionlabs.ai
- Kimi K2.6: What This Open-Weight Model Actually Means — kili-technology.com
- China's Moonshot AI raises $2B at $20B valuation — techcrunch.com
- Kimi K2.6 API Pricing & Benchmarks — openrouter.ai
- MoonshotAI/Kimi-K2 (모델 저장소) — github.com
이 글은 생성형 AI의 도움을 받아 작성되었습니다. 원본 자료를 기반으로 AI가 초안을 생성하고, 작성자가 검토·편집하였습니다.
'IT' 카테고리의 다른 글
MCP·RAG에 API를 넣기 전에 설명을 다듬어야 할까 — 모델이 똑똑해져도 남는 enrich의 이득, 사라지는 이득 (0) 2026.09.28 Gemini는 왜 OpenClaw의 OAuth 연동만 콕 집어 막았나 — 인증 토큰에 숨은 요금 계약 (0) 2026.09.27 DeepWiki는 이제 필요 없을까 — 모델이 코드를 읽는 시대의 문서화 (0) 2026.09.26 GLM-5.3은 왜 갑자기 오푸스와 붙나 — 뼈대는 그대로 두고 후처리만 갈아 끼운 오픈 웨이트 모델 (0) 2026.09.24 나머지를 다 고정하고 내 것만 빠르게 — 그게 fixture인가, 최선인가 (0) 2026.09.23 합성 모니터링 — 아무도 안 쓰는 새벽 3시에 로그인·결제를 대신 밟아 주는 로봇 (0) 2026.09.22 카나리 릴리스 — 새 버전을 사용자 1%에게만 먼저 흘려보내고 지표로 판정한다 (0) 2026.09.22 스모크 테스트 — 배포 직후 '불이 켜지긴 하나'만 60초에 확인하는 얕고 빠른 그물 (0) 2026.09.22 테스트는 레벨마다 다른 질문에 답한다 — 로컬·통합·프로덕션에서 공통 테스트를 반복해야 할까 (0) 2026.09.22 Acorn은 플러그인도 테마도 아니다 — 워드프레스 안에 라라벨을 심는 물건의 정체와 2026년 현황 (0) 2026.09.21