-
DeepWiki는 이제 필요 없을까 — 모델이 코드를 읽는 시대의 문서화IT 2026. 9. 26. 21:00
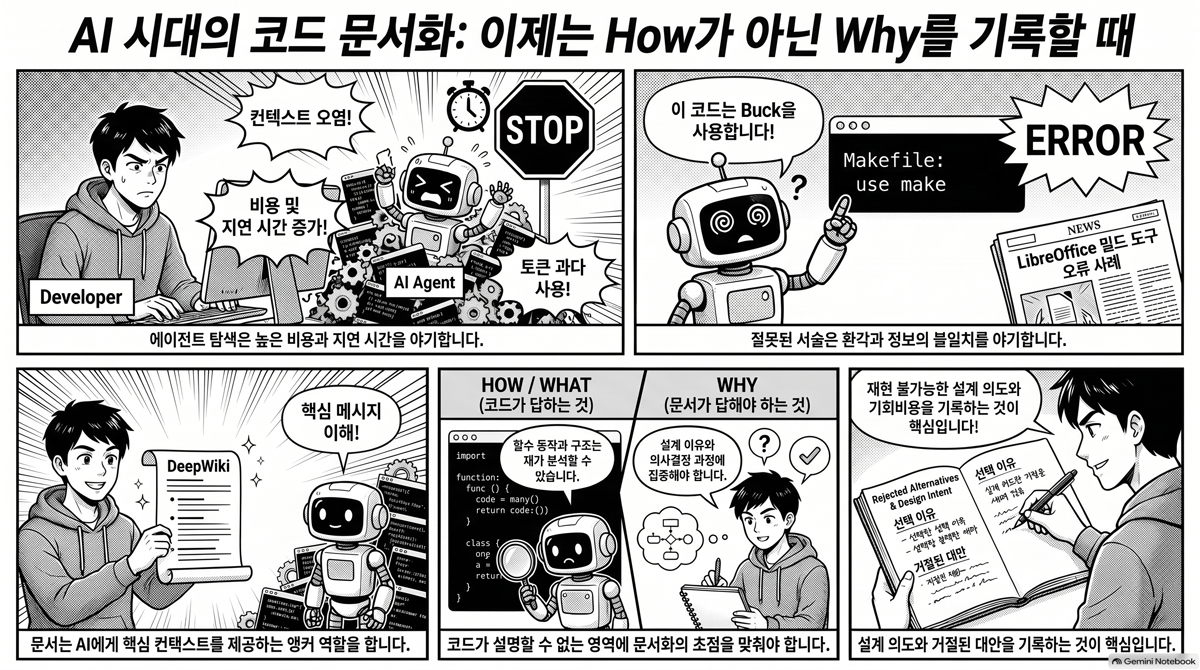
▶ 동영상 개요 — DeepWiki는 이제 필요 없을까 — 모델이 코드를 읽는 시대의 문서화
7분 12초 — 모델이 코드의 how를 공짜로 재구성해 주는 시대에도 DeepWiki 같은 코드 기반 문서화가 값을 하는 이유(agentic search의 컨텍스트 오염·토큰·… — NotebookLM 동영상 개요로 생성 🎧 오디오 개요 — DeepWiki는 이제 필요 없을까 — 모델이 코드를 읽는 시대의 문서화
31분 2초 — 모델이 코드의 how를 공짜로 재구성해 주는 시대에도 DeepWiki 같은 코드 기반 문서화가 값을 하는 이유(agentic search의 컨텍스트 오염·토큰·…. 화면은 이 글의 인포그래픽 한 장 고정 — NotebookLM 오디오 개요로 생성 어느 저장소든 주소창의
github.com을deepwiki.com으로 바꾸기만 하면, 그 코드베이스를 통째로 읽어 아키텍처 다이어그램과 모듈 설명이 붙은 위키가 몇 초 만에 뜬다. Cognition(자율 코딩 에이전트 Devin을 만든 회사)이 2025년 4월 25일 공개한 DeepWiki다. 공개 시점에 이미 상위 공개 GitHub 저장소 5만 개 이상을 인덱싱했다고 밝혔다. 처음 붙여 봤을 때 감탄이 먼저 나왔다 — 낯선 코드를 이렇게 빨리 요약해 준다는 게 신기했다.그런데 며칠 쓰다 보니 이상한 멈칫이 왔다. 요즘 모델은 컨텍스트 창이 100만 토큰을 넘고(GitHub Copilot은 2026년에 1M 컨텍스트를 얹었다), 에이전트가 저장소를 스스로 뒤져 가며 코드를 읽는다. 그렇다면 모델이 그때그때 코드를 직접 읽으면 되지, 굳이 미리 만든 위키가 왜 필요한가? 이 글은 그 질문을 붙잡고, "여전히 값을 한다"는 답과 함께 무엇을 문서로 남기고 무엇을 남기지 말아야 하는지를 정리한 기록이다.
모델이 코드를 직접 읽는데, 왜 미리 만든 위키인가
먼저 "모델이 읽으면 되지"가 실제로 어디서 비싸지는지 봐야 한다. 에이전트가 코드베이스를 직접 탐색하는 방식(agentic search — 에이전트가 스스로 grep하고 파일을 열어 가며 답을 찾는 것)과, 미리 만든 위키를 한 번에 읽는 방식은 겉보기엔 둘 다 "코드를 이해한다"지만 비용 구조가 전혀 다르다.

다이어그램 설명. 같은 목표("코드베이스를 이해한다")에서 두 갈래로 나뉜다. 직접 탐색하는 쪽은 grep과 파일 열기를 반복하는데, 문제는 읽은 파일이 전부 컨텍스트 창에 남는다는 것이다. 막다른 검색, 잘못 걸린 파일, 거부된 경로까지 누적되면서 대여섯 번의 탐색 턴 뒤에는 컨텍스트가 노이즈로 오염된다. 한 분석은 무관한 내용이 중간에 끼면 모델 성능이 30% 넘게 떨어질 수 있다고 봤고, AST(Abstract Syntax Tree — 코드를 구문 단위로 파싱한 트리) 기반의 가벼운 코드 검색으로 바꾸면 토큰을 70%까지 아낄 수 있다고 보고했다. 미리 만든 위키를 읽는 쪽은 이 탐색 비용을 생성 시점에 한 번 치르고, 이후에는 요약된 결과만 로드한다.
지연시간도 무시 못 한다. 100만 토큰 컨텍스트에 코드를 통째로 밀어 넣는 실험에서는 정확도가 오르긴 했지만 첫 토큰이 나오기까지 30~40초가 걸렸다. 사람이든 CI 파이프라인이든, 매 질문마다 그 시간을 다시 치를 수는 없다. 여기에 사람 온보딩이라는 축이 하나 더 있다 — 신규 기여자가 낯선 저장소에 발을 들일 때, 함수 하나하나를 따라 읽기 전에 "이 시스템은 대략 이렇게 생겼다"는 지도를 먼저 손에 쥐는 것과 아닌 것은 다르다.
흥미로운 실측도 있다. LLM이 생성한 컨텍스트 파일(저장소 루트에 두는 안내 문서)이 코딩 에이전트의 작업 성공률을 평균 2.7%p 올렸고, 문서가 거의 없는 저장소에서는 사람이 직접 쓴 안내보다 오히려 나았다는 연구가 있다. 즉 자동 생성 문서는 장식이 아니라 에이전트의 실제 성능을 끌어올리는 입력이다. "모델이 좋아졌으니 문서는 필요 없다"가 아니라, 좋아진 모델을 더 싸고 빠르게 쓰기 위해 미리 만든 문서가 여전히 필요하다는 쪽이 맞다.
그런데 자동 문서화는 조용히 틀린다
여기까지면 "그럼 다 자동 생성하자"로 끝날 것 같지만, DeepWiki 자신이 반례를 만들었다. 2025년 8월, 여러 오픈소스 유지보수자들이 자기 프로젝트의 DeepWiki 페이지가 틀렸다고 공개적으로 지적했다.

다이어그램 설명. 코드에서 서술을 자동 생성할 때 걸리는 함정 네 가지를 한데 모았다. 첫째, 환각이다 — DeepWiki는 LibreOffice의 빌드 시스템을 실제 Make 대신 "Buck을 주 빌드 시스템으로 쓴다"고 허위로 적었다. 둘째, drift다 — 코드는 계속 바뀌는데 한 번 생성한 문서는 그 자리에 멈춰, 뚜렷한 오류 신호 없이 서서히 현실과 어긋난다. 셋째, 얕은 서술이다 — LLVM 페이지는 TableGen 같은 필수 도구를 통째로 빼먹으면서 덜 중요한 컴포넌트를 크게 다뤘다. 넷째, 근거 없음이다 — 어느 파일 어느 줄에서 나온 주장인지 앵커가 없으니, 그럴듯하지만 미묘하게 틀린 설명(Compiler Explorer의 설정 파일 설명이 그랬다)을 독자가 걸러낼 방법이 없다.
가장 무서운 건 유지보수자들의 반응이었다. "결국 사람들이 이걸 공식 문서로 믿게 될 것"이라는 말이 나왔다. 자동 생성 문서의 위험은 틀린다는 것 자체가 아니라, 그럴듯해서 틀린 줄 모른 채 신뢰된다는 데 있다. 근본 원인은 하나로 모인다 — 큰 파일이나 낡은 설정에 모델이 고착하고, 여러 작은 파일에 흩어진 진짜 핵심을 놓치며, 무엇보다 주장을 코드의 특정 지점에 묶어 두는 grounding(근거 앵커)이 없다는 것이다.
그래서 무엇을 문서로 남겨야 하나 — how가 아니라 why
실패 사례를 뒤집으면 답이 보인다. 모델이 코드를 잘 읽을수록, 코드에서 다시 뽑아낼 수 있는 정보를 문서로 중복 저장하는 것의 값어치는 0에 수렴한다. 함수가 무엇을 하는지(what), 어떻게 동작하는지(how)는 코드가 곧 정답이다. 모델에게 물으면 그 자리에서 재구성해 준다. 반대로 코드에 흔적조차 남지 않는 정보가 있다 — 왜 이렇게 설계했는지, 어떤 대안을 검토하고 왜 버렸는지, 무엇을 포기하는 대가로 무엇을 얻었는지. 이것이 문서화의 진짜 자리다.

첫 번째 비교 블록. 여기 모인 것들은 전부 코드를 파싱하면 결정적으로 뽑아낼 수 있다. 함수의 동작, 호출 관계, 타입 시그니처는 모델이 코드를 읽는 순간 재현된다. 이런 정보를 산문으로 다시 적는 건 "코드를 영어로 다시 읽어 주기"에 가깝고, 코드가 바뀌는 순간 drift의 원천이 된다. 자동 생성이 잘하는 영역이자, 동시에 굳이 사람이 붙들고 있을 필요가 없는 영역이다.

두 번째 비교 블록. 이쪽은 코드를 아무리 정교하게 파싱해도 나오지 않는다. 왜 A가 아니라 B를 골랐는지, 검토했다가 버린 선택지가 무엇이었는지, 그 결정이 무엇을 희생했는지는 사람의 머릿속에서만 존재하다 사라지는 정보다. Michael Nygard가 2011년 제안한 설계 결정 기록(Architecture Decision Record)이라는 가벼운 포맷이 바로 이걸 겨눈다. 그가 든 근거는 지금도 유효하다 — "코드를 읽으면 어떻게 동작하는지는 누구나 알 수 있지만, 왜 그렇게 만들었고 어떤 대안을 거절했는지는 문서 없이는 알 수 없다." 그래서 이 기록의 절반은 거절된 대안과 그 사유여야 한다. 그게 없으면 몇 달 뒤 같은 트레이드오프를 처음부터 다시 논쟁하게 된다.
정리하면 이렇다. "커밋은 무엇이 바뀌었는지 말해 주고, 결정 기록은 왜 그 변경을 받아들였는지 말해 준다." 모델이 how를 공짜로 재구성해 주는 시대일수록, 사람이 남길 문서는 재구성 불가능한 why 쪽으로 무게중심이 옮겨 가야 한다.
피해야 할 것 — drift와 근거 없는 서술
문서화의 자리를 why로 옮긴다고 자동 문서화를 버리라는 뜻은 아니다. how 문서도 여전히 유용하다 — 단, 사람이 손으로 유지하지 않고, 코드가 바뀔 때마다 코드에서 다시 생성한다는 전제에서다. 이 지점을 상용 도구들이 이미 붙들고 있다. Swimm은 문서에 코드 스니펫을 결합해 두고, 참조된 코드가 바뀌면 영향받는 문서를 자동으로 찾아 문서가 갱신될 때까지 CI 빌드를 실패시킨다. Mintlify는 GitHub 앱이 PR의 변경을 감지해 문서를 자동 갱신하고 낡은 설명에 플래그를 단다. 둘 다 같은 진단에서 출발한다 — "문서는 drift한다. 코드 변경에는 강제된 merge 경로가 있지만, 문서 갱신은 늘 별도의 수동 단계이기 때문이다."
여기서 grounding이 두 번째 축으로 들어온다. 자동 생성 서술이 조용히 틀리는 걸 막으려면, 모든 사실 주장이 검증 가능한 근거를 달고 있어야 한다 — "이 주장은 이 파일 이 함수에서 나왔다"는 앵커 말이다. 앵커가 있으면 사람도 모델도 그 자리로 가서 진위를 확인할 수 있고, 코드가 바뀌어 앵커가 깨지면 그 문장이 낡았다는 신호가 된다. DeepWiki의 LibreOffice·LLVM 사고는 정확히 이 앵커가 없어서, 그럴듯한 오류가 검증 없이 페이지에 박힌 경우였다.
그래서 피해야 할 것을 한 줄로 줄이면 이렇다. 코드에서 재현 가능한 how를 사람이 손으로 관리하지 말 것, 근거 앵커 없이 서술을 생성하지 말 것, 그리고 자동 생성물을 "공식 문서"로 승격시키기 전에 반드시 사실을 검증할 것. 이 세 가지를 지키지 않은 자동 문서화는 온보딩을 돕기는커녕, 그럴듯한 오답을 조직의 공식 기억으로 굳혀 버린다.
정리 — 문서화의 무게중심을 옮긴다
모델이 코드를 읽는 능력이 좋아진다고 코드 기반 문서화가 죽지는 않는다. 오히려 그 능력을 싸고 빠르게, 그리고 오염 없이 쓰기 위해 미리 만든 문서가 여전히 필요하다. 바뀌는 건 필요 여부가 아니라 무엇을 남기느냐다. 코드에서 다시 뽑을 수 있는 how는 자동 생성에 맡기되 코드에서 재생성하고 근거로 묶고, 사람의 손은 코드에 절대 남지 않는 why — 왜 이렇게 했고 무엇을 버렸는지 — 에 쏟는다.
개인 프로젝트에 이 원칙을 적용한다면 규칙은 단순해진다. API 레퍼런스나 호출 그래프처럼 코드가 답인 문서는 손대지 말고 도구에 맡기고, 대신 "왜 이 구조를 골랐는가"를 결정할 때마다 거절한 대안까지 한 단락으로 남긴다. 코드가 답할 수 있는 것은 코드에게 묻고, 코드가 답할 수 없는 것만 사람이 적는다 — 이 경계선이 모델이 좋아질수록 더 또렷해진다.
참고한 공개 자료:
- DeepWiki 공식 소개 — cognition.com/blog/deepwiki (2025년 4월 25일, 5만+ 저장소 인덱싱)
- DeepWiki 정확성 논란 (LibreOffice·LLVM·Compiler Explorer 사례) — biggo.com/news/202508270142_DeepWiki_Accuracy_Concerns
- Agentic search의 컨텍스트 오염·토큰·지연 — morphllm.com/agentic-search
- LLM 생성 컨텍스트 파일의 성능 효과 (AGENTS.md 평가) — arxiv.org/pdf/2602.11988
- Michael Nygard, Documenting Architecture Decisions (2011) — martinfowler.com/bliki/ArchitectureDecisionRecord.html
- Swimm — living documentation / auto-sync — swimm.io/blog/sync-dont-sink-why-we-built-swimm-for-dev-teams
- Mintlify — 코드 스캔 기반 문서 자동 갱신 — mintlify.com/library/best-code-documentation-tools
- GitHub Copilot 2026, 1M 컨텍스트 — moxiedocs.com/blog/github-documentation-gets-ai-upgrade-with-new-copilot-features-in-2026
이 글은 생성형 AI의 도움을 받아 작성되었습니다. 원본 자료를 기반으로 AI가 초안을 생성하고, 작성자가 검토·편집하였습니다.
'IT' 카테고리의 다른 글
MCP·RAG에 API를 넣기 전에 설명을 다듬어야 할까 — 모델이 똑똑해져도 남는 enrich의 이득, 사라지는 이득 (0) 2026.09.28 Gemini는 왜 OpenClaw의 OAuth 연동만 콕 집어 막았나 — 인증 토큰에 숨은 요금 계약 (0) 2026.09.27 Kimi K2는 정말 오푸스·소네트와 붙나 — 1조 개 중 320억만 켜는 오픈 웨이트 모델의 정체 (0) 2026.09.25 GLM-5.3은 왜 갑자기 오푸스와 붙나 — 뼈대는 그대로 두고 후처리만 갈아 끼운 오픈 웨이트 모델 (0) 2026.09.24 나머지를 다 고정하고 내 것만 빠르게 — 그게 fixture인가, 최선인가 (0) 2026.09.23 합성 모니터링 — 아무도 안 쓰는 새벽 3시에 로그인·결제를 대신 밟아 주는 로봇 (0) 2026.09.22 카나리 릴리스 — 새 버전을 사용자 1%에게만 먼저 흘려보내고 지표로 판정한다 (0) 2026.09.22 스모크 테스트 — 배포 직후 '불이 켜지긴 하나'만 60초에 확인하는 얕고 빠른 그물 (0) 2026.09.22 테스트는 레벨마다 다른 질문에 답한다 — 로컬·통합·프로덕션에서 공통 테스트를 반복해야 할까 (0) 2026.09.22 Acorn은 플러그인도 테마도 아니다 — 워드프레스 안에 라라벨을 심는 물건의 정체와 2026년 현황 (0) 2026.09.21